幻影彭的彩虹

寻遍这星空

某场考试T1

怎么说,题不难,但是需要想一下。

考虑右端点进行贪心的思路挺妙的。

某场考试T2

比较套路的题,先弄出一个 \(t\times n^4\) 的凑合做,然后发现两维转移系数独立,转移答案为三角形和形式乘上两维系数,可以考虑固定第二维,单独计算第一维不同转移系数对应的式子,每一种系数的变化量为 \(O(1)\),所以一次转移可以做到 \(O(n)\)。

某场考试T3

神仙题,考场上猜到树一定有解,但是想的是通过背包来构造解,事实上,可以归纳的证明每棵子树带来的差异可以取 \([-sz_u,sz_u]\) 中的任意值,所以对于树暴力构造一条从根到某个点的路径,可以满足路径两边大小相等。

考虑图上的结果。

09 年的一篇集训队论文告诉我们对于图上的问题,往往可以考虑其生成树的解法,从而进行拓展,发现无向图的生成树没有横插边,所以直接选取生成树上的答案,由于没有返祖边,所以原来合法的同样合法。

某场考试T4

也是比较套路的题。

很明显本质上是给你个一次函数做路径边权,然后 \(k\) 的值为 \(1\),所以计算出每个点每个 \(k\) 的值即可。

我选择分层图跑 \(dij\) 外加大力卡常,但这是一种非常 \(SB\) 的行为,\(dij\) 本质上还是保证了转移的无环性,但 \(TM\) 这个转移本来就无环还跑你大爷的 \(dij\),暴力 \(dp\) 出来做凸包就行。

然后从 \(n\) 的各个在凸包上的 \(k\),倒推回去看那些点可能被用到,倒推可以写成记搜,这样只用存一遍边。

某道 GCD 题

给一个 \(n\times m\) 矩阵,元素为 \(1-n\times m\) 的排列,问你所有子矩阵的 GCD 之和。

反正我想的是考虑一个右下角,移动左上角来统计答案,这样的话考虑到 gcd 的变化次数是\(\log\) 的,说不定有救,但是需要完成区间取 GCD,这个不好做。

想一下,这个做法没有利用到每个数只出现一次的性质,通常这种只出现一次的性质往往和倍数这些相联系,不妨换个思路考虑,考虑 \(i\) 的倍数的子矩阵的数量,然后发现容斥一下就可以得到答案。统计 \(i\) 的倍数的子矩阵数量不难。

NOI2021D1T1

我想了一下,链是会做的,树链剖分,就是把树变成 \(\log\) 个链来做。

然后其实每条重链按照链的方式来做,重链的交汇处需要特殊处理。

不妨把边下放到点,发现如果一个点的父亲的修改时间晚于该点的修改时间,那么这个点所代表的链就没用,所以对每个点维护两个东西,一个是该点的修改时间,另一个是该点代表的边是否被修改成重边。

查询的时候对链的交界处需要查修改时间判断是否有效。

其实有个更简易的方式,就是把修改看成染色,一条边有贡献当且仅当其两个端点颜色相同,这个很容易用树剖维护。

这两种方式其实体现出处理边的两种方式——下放到点考虑,考虑两个端点的状态。

需要灵活运用这两种方式解题。

随记20220904

双膝折叠,跪坐在算不上柔软的沙发上,两臂枕在凸起的窗沿。我有些懒散的将下巴靠在小臂,又竭力不让窗沿压迫小臂,以免有些脆弱敏感的手部神经受到刺激,\(P=\frac{F}{S}\),一个非常优美的公式。我开始估算手臂和窗沿的接触面积,我脑袋的半径,以便带入人体平均密度计算出手部受到的压强相当于几个大气压。

不得不说,物理和数学公式都是优美的,只需要用上统一的几个名字,就能尽情将身边的一切等效。或者说,公式本身不够优美,但是人们设计的物理单位是那么的精巧,避免了那些繁杂的常量,一些无比熟悉的数字又飞入脑海,\(e\approx2.718\),\(\pi\approx3.1415927,G\approx6.67\times 10^{-11}m^3kg^{-1}s^{-2}\cdots\)。

将越跑越远的联想收回来,生活不是科学,生活不需要那些能精确到小数点后几十几百位的数字。生活的美感,是一种无法用任何数学语言描述的美感。

陶渊明的 “采菊东篱下,悠然见南山”,带来田园的悠然自得。

王维的 “大漠孤烟直,长河落日圆”,给出荒凉的独特答案。

马致远的 “枯藤老树昏鸦,小桥流水人家,古道西风瘦马。”,留下秋日的那份伤感。

但我只是一个平常的理科生,对感性的语文并不敏感,但窗外的宁静,也足以让我有感写下一些拙劣幼稚的文字。

我不知道今年的干旱具体给天府之国带来了多大的影响,但是从居民区的停电和学校的被迫放假还是能够管中窥豹。刚回到学校没多久,COVID 就横扫四川所有中学,没有一所逃过延迟开学的结局,即使是强硬如某校,也只不过多坚持了半天,就匆匆将神兽们赶了回去——就在高温假结束后的 2 天。

所以我就在这个时候,趴在了窗前,半夜的街道很冷清,只能听见百草路地铁口 “握紧扶手,注意脚下” 的提醒。目光向上 90度,我甚至能分辨出夜空中的云朵,它们和蓝色的天空还有一丝界限,但其实都很暗,它们一起向目光尽头的高楼收敛。如果你想具体的体会一下,你可以打开 mspaint,天的颜色是 0 60 85,云的颜色是 212 212 212,而它们收敛向 69 24 34。RGB 空间还是很无力,区区 3Byte 无法描绘出世界上的,甚至无法描绘出人肉眼可以分辨的所有颜色。

黯淡的云朵没有动作,视野的右侧有一颗明亮的光点,它是星星。按照不知道从哪里得知的观星技巧,我快速的扫过窗口狭小的天空,又有数十的光点在视野中闪过,但我尝试正眼捕捉,它们又藏入了深色的天空,像是一个个纯黑背景下的白色像素点,于缩放后在显存中被彻底删除,我再也找不到它们。即使有着凹透镜的帮助,变形略显严重的晶状体也失去了精确的将波长仅有 \(300-500nm\) 的可见光折射到每一个感光细胞的能力。

一段时间的沉寂后,波浪状的云遮住了唯一那颗被轻易捕捉到的星星,视野渐渐下移,移过 “立德树人” 四个大字,是熟悉的水泥路。很突然,沥青从路面翻起,回到工人的铲子,回到工程车辆,回到工厂,最后在分馏器中重新变成原油,再顺着磕头机的管道流入地底。远处的高楼被荒芜的草地替换,眼前的工地,正热火朝天。。。

又重归沉寂,只有略冷的风打在脸上,我看了看最近都在 1.5km 之外的高楼,并细细感受周遭的气温,思考着这股风的来历,但已经有些陌生的地理和物理知识不再能闪着光告诉我答案。

shutdown -f,我告诉大脑,但又用留在海马体里的数据恢复了这段文字,像是被设置了关机命令为休眠的计算机。

从区间 DP 到线性 DP

题目

你有 \(n\) 个区间,每个区间是 \(l,r,w\) 三个参数描述,表示左右端点和权值,如果区间有交(包括端点),那么就在有交的两个区间连边,形成一张无向图,有个参数 \(k\),你需要删去一些区间,使得每个联通块大小不超过 \(k\)。

  • \(n\leq 500\)

  • \(n\leq 2500\)

思考

首先这肯定不是一个图论问题,给一张图做这个问题是 \(NP\) 的,所以要利用好区间的性质。

先把区间离散化。

发现可以考虑一段区间 \([l,r]\),只考虑在区间内的区间,计算其答案,有两种方式,第一种是将区间继续划分成两个子区间,划分区间的过程,体现出了全局最优的思想,即我们假定了当前区间内的所有线段全部联通,这样不一定能在此处取到最优解,但一定可以在向下动态规划的过程中得到最优解,另一种是直接在当前区间选最大的 \(k\) 个保留。

划分区间的方式,就是选一个地方断开,删掉越过这个地方的所有区间,变成两个子问题。

有了这样的思路,我们很容易设计出一个 \(O(n^3)\) 的区间动态规划出来。

优化

\(O(n^3)\) 可以通过 \(n\leq 500\) 的数据点,但是无法通过 \(n\leq 2500\),所以需要优化为 \(O(n^2)\),其中预处理 \([l,r]\) 的复杂度是 \(O(n^2\log n)\) 的,但是常数较小能够接受。

于是可以考虑利用区间 \(dp\) 的一些常见优化手段,打个表,发现决策点并不单调,所以对于这类 \(2D1D\) 问题我们有点束手无策。但是感觉上记录区间有点浪费,于是考虑能不能线性的搞出来。发现如果设 \(dp[i]\) 表示考虑前 \(i\) 个的答案,从 \(j<i\) 转移,\([j,i]\) 采用直接减少到 \(k\) 的方式,也能得到和区间DP方式相同的转移考虑。

所以被优化成了 \(O(n^2)\)。越过每个点的区间总数,是可以动态维护的,均摊 \(O(1)\)。

从2D1D到1D1D

其实这类问题,是伪区间DP问题,比较它和真区间DP问题,比如《石子合并》,《优雅的闪电》的差异。它本质上是 1D1D 问题,石子合并很明显就是需要体现区间合并的顺序,所以必须采用区间DP。优雅的闪电的转移,无法被 1D1D 的转移考虑完全,所以仍然需要区间 DP。

关于一些 2D1D 的问题,可以仔细考察它的转移,能否被 1D1D 的形式描述,以便优化。

标准库

  • STL 内的所有基于比较的容器,都需要定义一个满足严格弱序的比较符号 <,要求如下:
    • 满足传递性:\(a<b,b<c\rightarrow a<c\)
    • 不能同时满足 \(a<b\) 且 \(b<a\)
    • 如果 !(a<b)&&!(b<a) 那么 a=b
  • 除开 array 之外的所有 STL 容器,定义时都会初始化,即初始化为空或者(全为 0,对于 bitset)。
  • 基于比较的容器,需要定义友元类型的大小比较符号,因为实现的时候使用了右值做比较。

priority_queue

默认是大根堆,跑得很快,1 秒 \(3\times 10^6\)

如果需要实现可以删除的优先队列,必须保证每次删除时对应元素存在。

构造方式 priority_queue<type,container,cmp>,container 是实现 priority_queue 的容器,一般用 vector,cmp 是比较算子(因此它是一个类名)。

通过 greater<typename> 可以用重载的 > 构造出一个大于算子。

map

本质上是 set<pair<T1,T2>>,见 set。

set

insert

可以插入一段区间,支持数组,同类型的 set vector 容器。

开 O2,\(1\) 秒 \(1.5\times 10^6\) 次操作。

如果接下来的一段插入有序,开 O2,\(1\) 秒 \(4.5\times 10^6\) 次,所以尽量排序后再插入。

erase

开 O2,\(1\) 秒 \(1.5\times 10^6\) 次操作。

如果接下来的一段插入有序,开 O2,\(1\) 秒 \(4.5\times 10^6\) 次。

迭代器操作

开 O2,\(1\) 秒 \(10^7\)。

遍历

1
2
for(auto v:st)
for(auto it=st.begin();it!=st.end();it++)

以上两种均为 \(O(n\log n)\)

开 O2,\(1\) 秒 \(10^7\) 次操作。

unordered_set

基础操作相比 set 快 \(2\) 倍。

有序操作和 set 效率差不多。

unoedered_map

本质上是 unordered_set<pair<T1,T2>>。

vector

比较理想的一个容器。

push_back()

一个 vector 做 push_back 需要 log 次 new,而 new 操作一般只能接受 \(2\times 10^7\) 次,所以尽量避免用太多 vector,如果能事先确定容器的 capacity,最好用 resize

iterator insert(iterator,val)

将 val 插入 iterator 位置,原 iterator 位置往后移动。

复杂度 \(O(n)\),但是跑得飞快。

iterator erase(iterator)

删除 iterator 位置的值,返回原容器(删除前)下一个位置的 iterator。

iterator

这东西的迭代器本质上是个指针,但是不能和指针做强转,所以 iterator 在被 erase 后会指向错误的数据,不同于 set 这一类基于 RBT 的容器。

内存过程

调用析构函数之前,vector 的内存不可能被释放,push_back 或者 resize 如果导致了内存改变,会开辟一块新的内存并将原有数据全部拷贝过去,保证内存地址的连续,同时原有迭代器全部失效。

vector 所有的 \(O(n)\) 操作都很快,如果题目性质决定了很可能 \(O(n^2)\) 卡不满,那么 vector 可以得到很高的分数。

拓展库

一个 C++ 拓展库,STL 升级版,C++11 特性。

gp_hash_table

Introduction

如名称,哈希表,比 unordered_map 快 3~4 倍,用法完全一样,你值得拥有。

效率 1S 能做 4e7 次基本操作

在 ext/pb_ds/assoc_container.hpp 中。

如果对非标准结构,例如类和 pair ,容器等,需要自己写哈希方法,哈希方式为一个类,重载了 () 运算,该重载必须被声明为常函数,且参数必须为常值引用。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
#include<ext/pb_ds/assoc_container.hpp>
__gnu_pbds:: gp_hash_table <int,int,hash_fun> mp;
struct node{
int a,b;
friend bool operator ==(const node &x,const node &y){
return x.a==y.a;
}
};
struct hash_fun{
int operator ()(const node &a) const{
return a.a;
}
};
__gnu_pbds:: gp_hash_table<node,int,hash_fun> mp;
mp.insert(make_pair(1,2));
mp[2]=3;
if(mp.find(2) != mp.end()){
printf("%d\n",mp.find(2)->second);
}

Tests:

这里只放关键部分,其余实现见代码

测试环境为 Windows10,CPU 型号为 Inter I7-9750H,内存 16GB, 2667Mhz

命中率对速度影响:

1
2
3
4
5
6
7
8
gen_data(1e6,4e7,8,7);//hit rate:87.5%
gp.clear();um.clear();
Test_Speed(gp);//878ms
Test_Speed(um);//3107ms
gen_data(1e6,4e7,8);//hit rate:12.5%
gp.clear();um.clear();
Test_Speed(gp);//1351ms
Test_Speed(um);//4168ms

插入和查询次数调整:

1
2
3
4
5
6
7
8
9
10
11
12
gen_data(2e6,4e7,4,1); //插入 2e6
gp.clear();um.clear();
Test_Speed(gp);//1475
Test_Speed(um);//4728
gen_data(5e6,4e7,4,1);
gp.clear();um.clear();
Test_Speed(gp);//1445
Test_Speed(um);//5038
gen_data(1e7,4e7,4,1);
gp.clear();um.clear();
Test_Speed(gp);//1877
Test_Speed(um);//6128

插入很多,查询很少。

1
2
3
4
gen_data(2e7,4e6,50,1);
gp.clear();um.clear();
Test_Speed(gp);//1690
Test_Speed(um);//8383

其实插入操作比较慢是正常的,内存占用大了之后自然就慢了。

另外,手写哈希表探测法还有救,拉链法直接抬走(你写代码的时候考虑过 CPU cache 的感受吗?)。

插入较少且全部在查询前面 cc_hash_table 的效率优于 gp_hash_table。

Tree

虽然有这个东西,但是还是应该学习如何写平衡树。

效率还可以,开 O2 和以前手写差不多,估计现在手写的会快一些,不过问题不大。

Geogebra 计算器简易教程

如果本文讲的不够精确,可以继续上网搜索教程。

格式

数学公式格式直接支持 LaTex 和 wolframalpha 提供的数学公式,也可以按照它的提示写。

乘方为 ^,分式直接写 /。

内置 ln sin cos 等常用函数,写约定的函数名即可提示。

求导可以直接写 \(f'\)

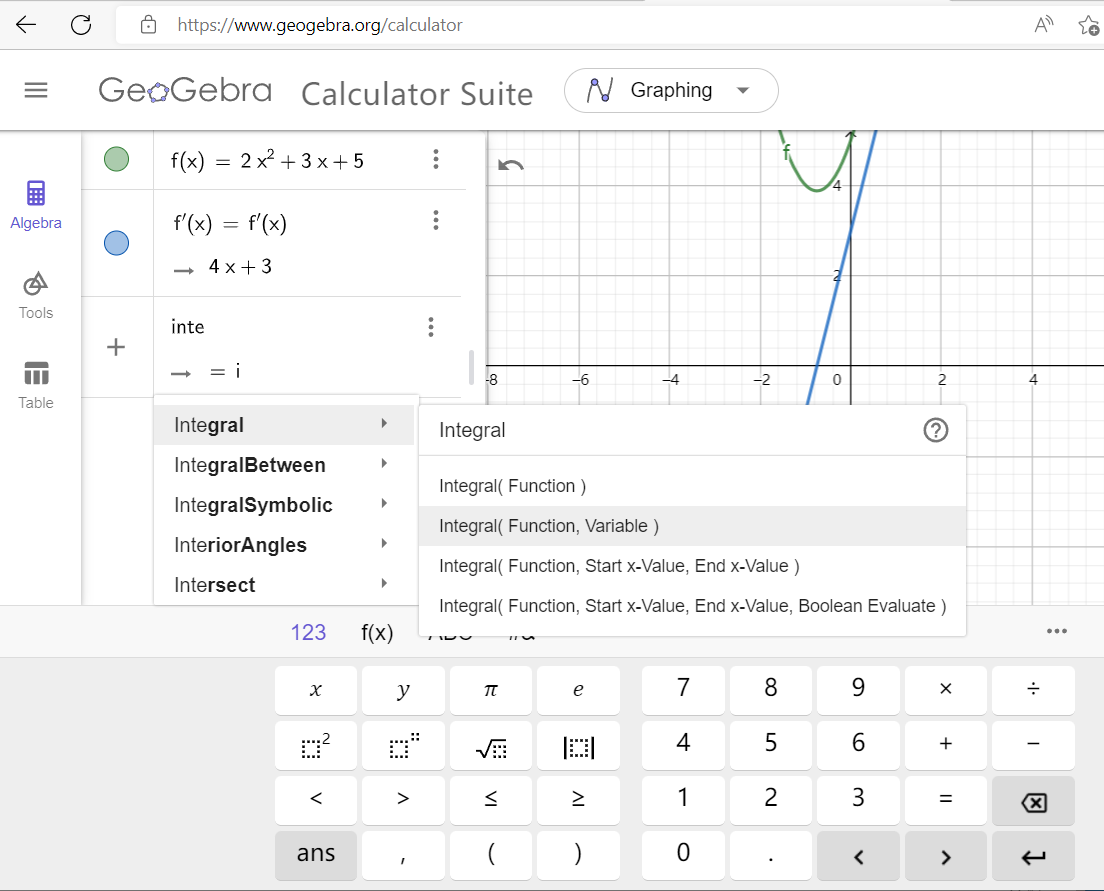
积分输入 integral,会提示参数,默认对 \(x\) 做不定积分。

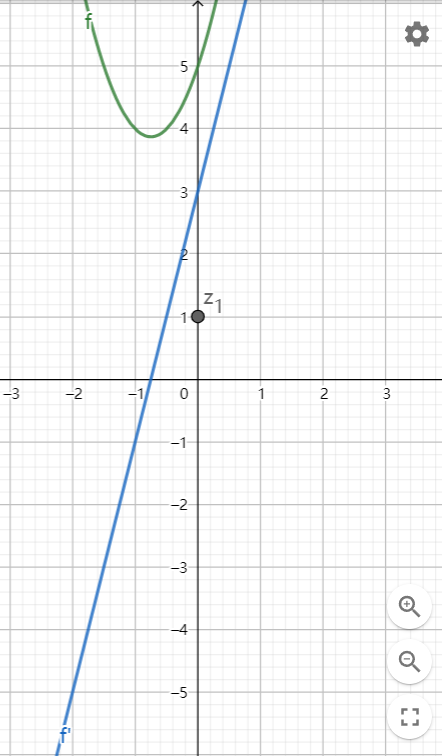
E1

可以看到下面还有一些特殊函数的提示框,可以根据这个输入。

操作

一般只会用到 Algebra 区域的东西。

鼠标拖动可以调整坐标系显示区域,滚轮调整显示精度。

右下角的三个按钮中前两个可以起到滚轮的作用。

E2

ctrl+z 撤销上一步操作,ctrl+y 取消上一步撤销操作,一步操作的判定比较迷惑,你认为的多步操作可能被判定为一步。

设置

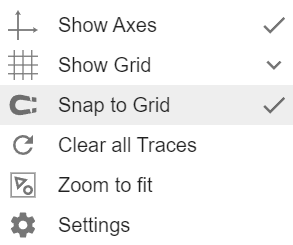
右上角有设置图标,见上图,点开后是是这样

E3

前三个全部默认勾上,不管,第五个 Zoom to fit 是自动调整的合适的大小,基本没用,点开第六个 Settings,主要用这个:

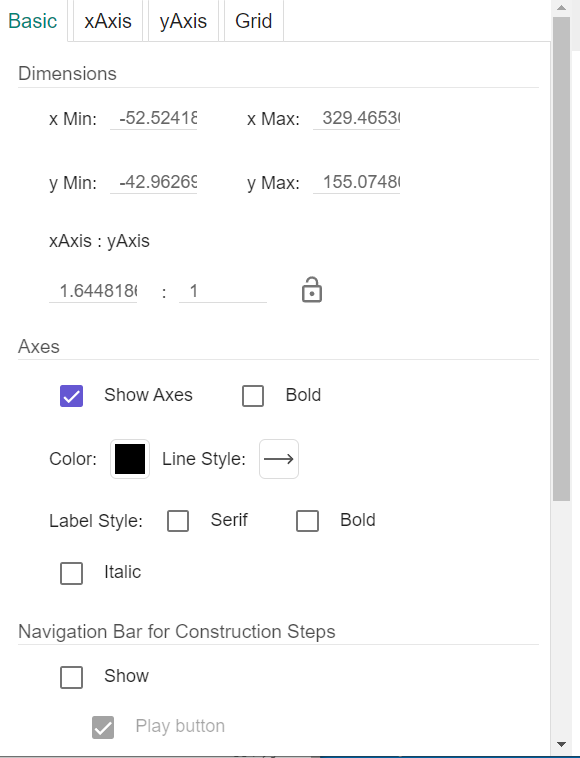
点进去之后只需要调 Basic,其它基本不用管。

E4

后面的基本不管,只需要调整 Dimensions,x Min,x Max,y Min, y Max 字面意义,显示的 \(x,y\) 坐标的最大值和最小值,如果调整的话会自动调整下面的 xAxis yAxis,也就是 \(x,y\) 坐标的比例,如果点了 xAxis 那个锁定小图标,那么调整 x Min 会自动调整其它两个值(y Min,x Min)以满足比例要求。

变量和函数设置

E5

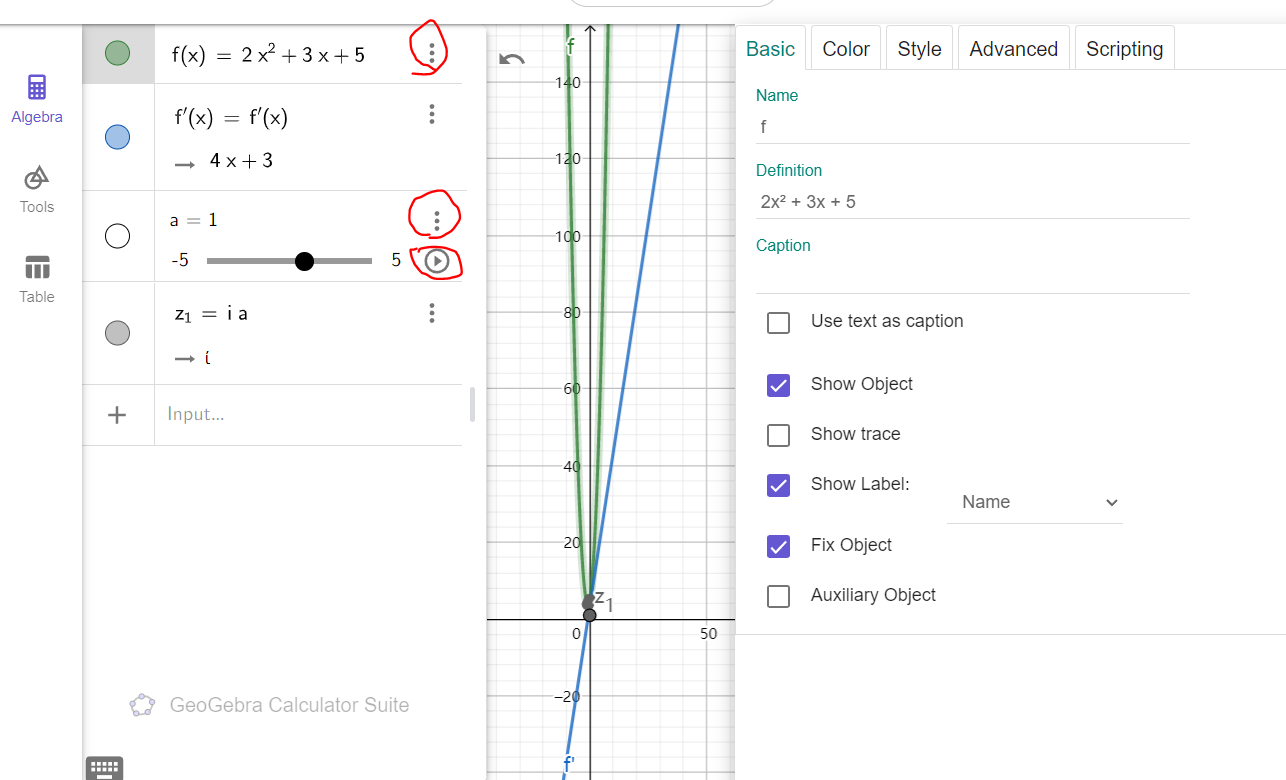
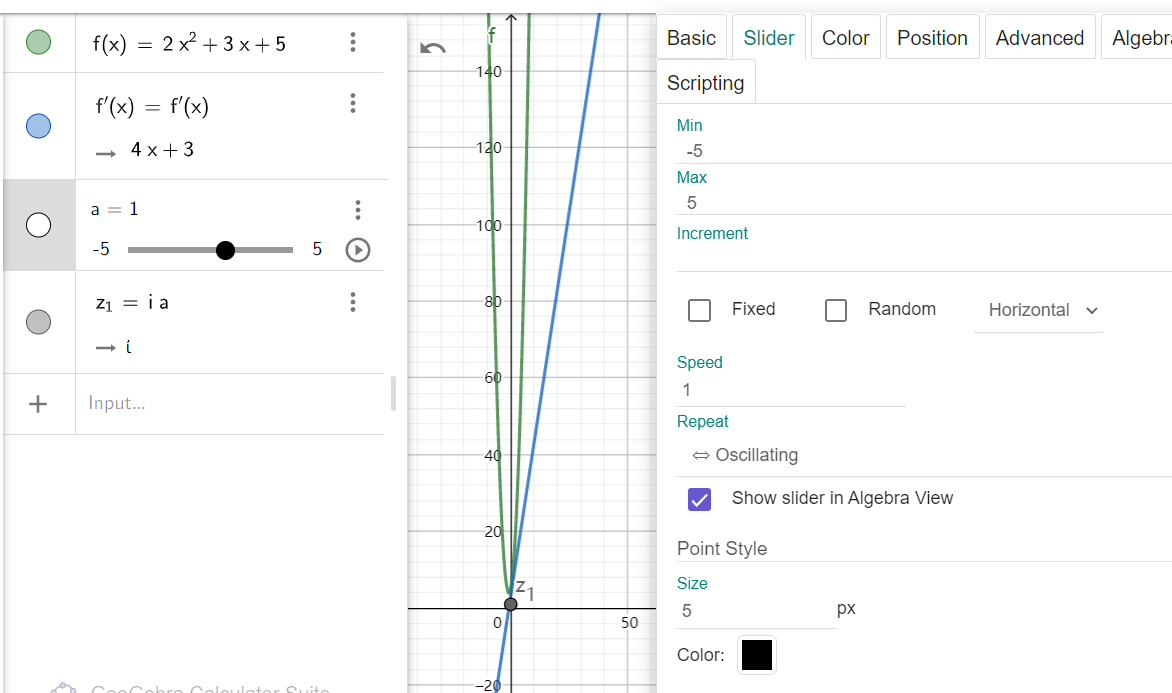
红圈圈出来的可以设置函数和变量,函数左边那个带颜色的框框可以点,点了之后就不再显示图像,当然再点一次就显示。

函数的设置没啥说的,看变量。

变量的那个播放按钮按下后会动态改变变量值,所有相关函数都会同时改变。

如果希望在函数中使用变量,一般先定义变量再写函数。

变量的设置中可以调整范围。

E6

在 Slider 选项中调整,调整的时候,上下界都调整好之后再按回车。

DEMO

洛谷P6025 题解

提供一个复杂度为的 \(O(\log n)\) 的,基于正常分析而非打表的做法,我认为这个做法比当前题解区的所有做法更加优美。

这道题相当不错,考察了线段树和位运算的理解。

题意

  • 一颗常规方式构建的线段树,求大小为 \(1,2,3,\cdots n\) 的线段树分别占用的最大空间,即最大下标。

  • 输出答案的异或和。

  • \(n\leq 10^{15}\)

构建代码为:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
void build(int k,int l,int r)
{
if(l==r)
{
//do something
//e.g. tree[k]=a[l]
return;
}
int mid=(l+r)>>1;
build(k<<1,l,mid);
build(k<<1|1,mid+1,r);
//do something
//e.g. tree[k]=tree[k<<1]+tree[k<<1|1]
}

原题意是求 \(f(l,r)\),但很容易转化为求 \(f(1,n)\),直接求 \(f(1,l-1)\bigoplus f(1,r)\) 即可。

分析

40PTS

首先,线段树建立的过程,就是从根往下走的过程,往左走,向当前编号的二进制表示后写一个 \(0\),往右走,就写一个 \(1\)。

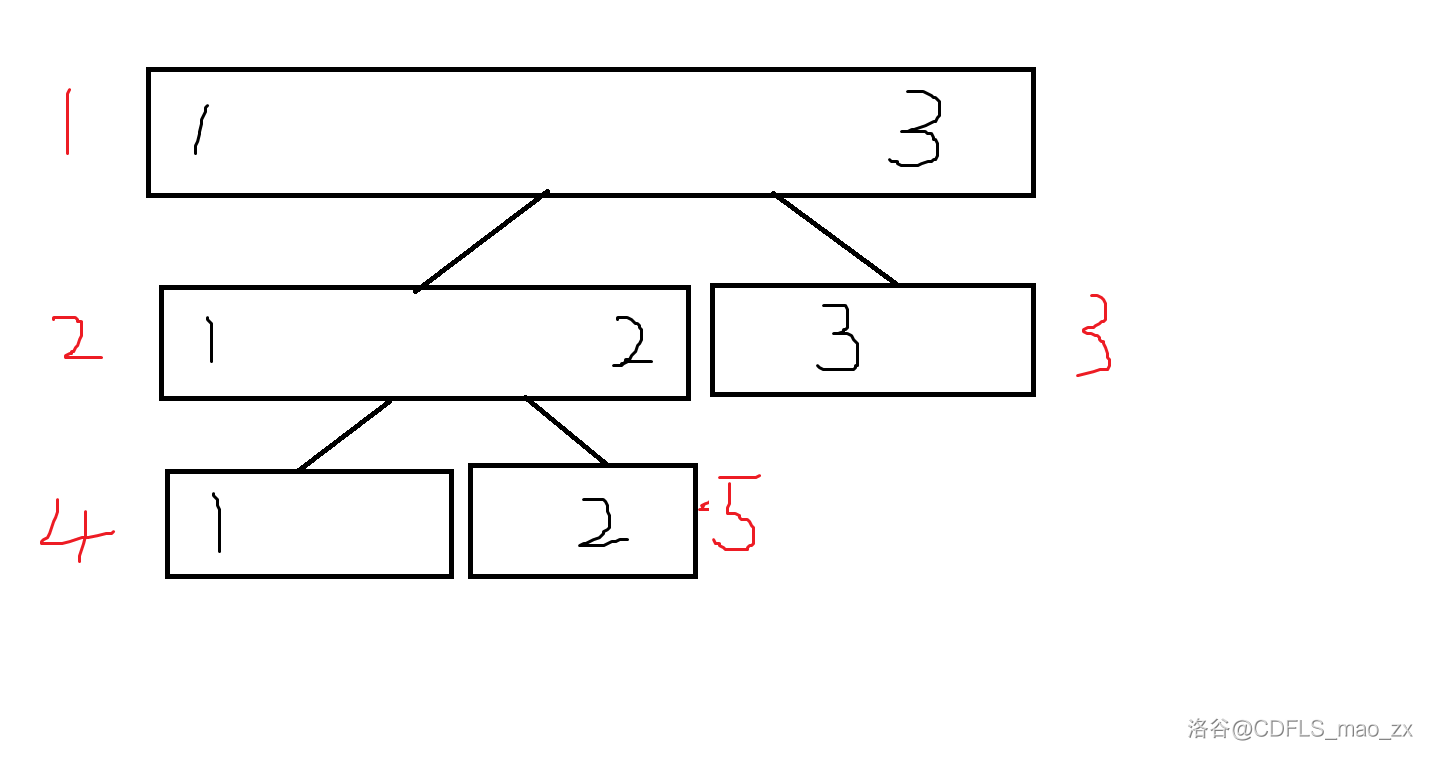
考虑线段树的最大下标在何处取到,由于右儿子下标相对较大,一个比较显然的想法是一直走右儿子,但是这样是错误的,显然的反例为 \(n=3\),如下图所示。

这个例子中,\([1,3]\) 节点的左儿子比右儿子多一层,所以出现了走左儿子最优的情况。

但是,如果某个节点处左右儿子高度相同,那么很显然应该走右儿子,因为当前这一步决定的位数是最高位。

所以走左儿子,当且仅当左右儿子高度不同,下面分析线段树的高度和长度的关系。

首先,子树构建情况只和长度有关,所以我们只关心长度而非左右端点,然后,长度为 \(2^k\) 的节点,构建出的树为一颗完全二叉树,其高度为 \(k\)。 此时,如果点数继续增大,那么高度为 \(k\) 的树就无法容下这么多节点,高度会变为 \(k+1\),所以,长度为 \((2^k,2^{k+1}]\) 的节点,构建出子树的高度为 \({k+1}\)。

容易发现,常规构建方式构建出的子树,其左儿子的大小不小于右儿子,且差值至多为 1,因此,如果出现了左右儿子高度不同,一定是左儿子比右儿子高,并且只能是一种情况,即长度的二进制表示为 \(100001\)。即除了最高位和最低位其余位均为 \(0\),只有这样才会出现左右儿子落在不同区间的情况。

所以我们对于一个 \(n\),很容易给出一个 \(O(\log n)\) 的计算方式,即:

1
2
3
4
5
int ask(int x,int now=1){
if(x==1)return now;
if(__builtin_popcount(x)==2&&x&1)return ask(x+1>>1,now*2);
return ask(x>>1,now*2+1);
}

其中 __builtin_popcount() 为内置函数,参数为 unsigned, int 也可以使用但不能为负数。

如果希望对 long long 使用,应改为 _builtin_popcountll()。

对每个数暴力求解即可。

100PTS

我们需要观察求解一个数的过程,不妨考虑二进制数 \(1001011\) 的计算过程。

手动模拟一下上述 \(\operatorname{ask()}\) 函数的调用过程,\(now\) 变量和 \(x\) 变量的值依次变为

1
2
3
4
5
6
7
8
now=00000001 x=1001011
now=00000011 x=0100101
now=00000111 x=0010010
now=00001111 x=0001001
now=00011110 x=0000101
now=00111100 x=0000011
now=01111000 x=0000010
now=11110001 x=0000001

容易发现,在出现 \(1001\) 这样的情况之前,我们将 \(now\) 左移一位并在后面写上了 \(1\),同时将 \(x\) 右移一位。

在出现 \(1001\) 之后,我们一直在往 \(now\) 后面写 \(0\),而 \(x\) 的变化则是先右移一位并将最后一位改为 \(1\)。

而最后 \(x\) 从 \(10\) 变为 \(1\) 时,我们在 \(now\) 末尾添加了一个 \(1\)。

不难发现,一个固定的 \(x\),我们最终得到的占用下标最大值,仅仅和它二进制表示下的最高位和第二高的为 \(1\) 的位有关,因为在这之前我们一定会添加 \(1\),而在这之后一定会往后添加 \(0\) 并在最后添加一个 \(1\)。

注意如果为 \(2^k\) 这样不存在次高位的数,我们需要特判。

所以我们有了一个比较显然的想法,即枚举二进制下最高位和次高位的位置,统计能取到这两个位置的数的数量,并异或上对应的权值。

这样的复杂度是 \(O(\log^2n)\) 的,我们考虑继续优化。

对于二进制下位数小于 \(n\) 的二进制下位数的所有数,实际上会有贡献的只有两个值,分别是 \(2^k\) 和 \(2^k+1\)。因为如果次高位不为第一位,那么能取到该值的数的个数一定为偶数个(低于次高位的位置可以任意填)。剩下这两个值的贡献都是可以 \(O(1)\) 计算的。

这样就只用考虑二进制下位数和 \(n\) 相同的数,同样的道理,如果次高位高于 \(1\),那么没有贡献,但需要注意的是,如果次高位取到了上界,例如 \(10110\) 中,次高位取到了第三位的 \(1\),那么由于必须小于 \(n\),实际上只有奇数个值可以取到,这样会带来一定的贡献,所以我们需要计算这种情况的答案,复杂度为 \(O(\log n)\)。

总复杂度\(O(\log n)\)。

可以参考我博客中的一些线段树的总结,会不定期更新。

从ZKW线段树看线段树的性质

参考代码

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
#include<bits/stdc++.h>
#define y1 y3647
#define int long long
#define pii pair<int,int>
#define low(x) ((x)&-(x))
using namespace std;
template<typename _type>
inline void read(_type &x){
x=0;int f=1;char ch=getchar();
while(ch!=45&&(ch>'9'||ch<'0'))ch=getchar();
if(ch==45){f=-1,ch=getchar();}
while(ch<='9'&&ch>='0'){x=x*10+ch-48;ch=getchar();}x*=f;
}
template<typename _type1,typename _type2>void cmin(_type1 &a,const _type2 b){if(a>b)a=b;}
template<typename _type1,typename _type2>void cmax(_type1 &a,const _type2 b){if(a<b)a=b;}
int i,j,k,n,s,t,m,tp1,tp2;
int solve(int x){
if(x==0)return 0;
if(x==1)return 1;
//特判边界情况
int res=1,h=log2(x);
//最高位从 10 开始枚举,所以 res 初值应该设置为 1
//h 为二进制下 x 的位数
for(i=1;i<h;i++){
res^=(1ll<<i+1)-1;
res^=(1ll<<i+1)+1;
//注意左移操作的 1 是 long long 级别的数
//计算 2^k 和 2^k+1 的答案,其它位置没有贡献
}
res^=(1ll<<h+1)-1;
//计算 2^h 的答案
if(low(x)==x)return res;
//如果 x=2^h,无需进行下面的步骤
res^=(1ll<<h+1)+1;
if(x-1==1ll<<h||x&1)return res;
//如果 x=2^h+1 或者末尾为 1,那么之后取到的值个数一定是偶数,无需计算。
int now=1;
while(__builtin_popcountll(x)>2||(x&1)==0){
now=now<<1|1;
x>>=1;
}
//模拟求解的第一步,找到对应的次高位,在这之前往后写 1
while(x){
x>>=1;
now<<=1;
}
//模拟求解第二步,往后写 0
now|=1;
//记得左右还需要异或 1
return res^now;
}
signed main()
{
// freopen(".in","r",stdin);
// freopen(".out","w",stdout);
// freopen(".in","w",stdout);
int l,r;
read(l),read(r);
printf("%lld\n",solve(r)^solve(l-1));
return 0;
}


题意

  • 给定一个序列 \(a\),长度为 \(2^n\),每次询问给定 \(mask\),询问 \(b_i=a_{i\bigoplus mask}\) 得到的 \(b\) 序列的最大字段和。

  • \(n\leq 18,q\leq 2\times 10^5\)

  • 原题意参考题意,这里做了一些不影响做题的转化。

思考

我们发现可以类似于线段树一样的去维护最大子段和,即考虑对一层维护其所有可能的交换序列的信息,然后计算一个节点左右儿子构成的区间的最大子段和,这样是可以得到正确答案的。

不难发现我们只需要知道一层的前缀和最大值和最小值就可以完成向上传递,这样的信息量是 \(O(1)\) 的,对于第 \(i\) 层,会影响它的值的只有它下面的状态,因为上面的状态如何不影响该层最大值和最小值的位置,因此不会影响其计算答案的结果。

因此很容易设计出一个 \(O(2^n\times n)\) 的做法,但是我觉得它有点难写。

所以我们考虑只分两层,预处理第一层的前缀和和最大值位置,最小值位置,扫描第二层计算答案,这样的话,复杂度为 \(O(2^{\frac{3n}{2}})\) ,约为 \(1.25\times 10^8\),能卡在边界上。

实现1

这是我们的第一份代码,得到了 TLE19 的成绩。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
#include<bits/stdc++.h>
#define int long long
using namespace std;
template<typename _type>
inline void read(_type &x){
x=0;int f=1;char ch=getchar();
while(ch!=45&&(ch>'9'||ch<'0'))ch=getchar();
if(ch==45){f=-1,ch=getchar();}
while(ch<='9'&&ch>='0'){x=x*10+ch-48;ch=getchar();}x*=f;
}
template<typename _type1,typename _type2>void cmin(_type1 &a,const _type2 b){if(a>b)a=b;}
template<typename _type1,typename _type2>void cmax(_type1 &a,const _type2 b){if(a<b)a=b;}
const int N=18;
int i,j,k,n,s,t,m,tp1,tp2;
int a[1<<N],ans[1<<N],mx[1<<N],mi[1<<N],sum[1<<N];
signed main()
{
read(n);
for(i=0;i<1<<n;i++)read(a[i]);
int now=0;
for(int mask1=0;mask1<1<<n/2;mask1++){
int gap=1<<n/2,max_val=0;
for(i=0;i<1<<n;i+=gap){
mi[i]=mx[i]=i;sum[i]=a[i^mask1],cmax(max_val,sum[i]);
for(j=i+1;j<i+gap;j++){
sum[j]=sum[j-1]+a[j^mask1];
if(sum[j]>sum[mx[i]])mx[i]=j;
if(sum[j]<sum[mi[i]])mi[i]=j;
cmax(max_val,sum[j]-sum[mi[i]]);
}
}
for(int mask2=0;mask2<1<<n;mask2+=gap){
ans[mask2^mask1]=max_val;
int min_val=0,sm=0;
for(i=0;i<1<<n;i+=gap){
cmax(ans[mask2^mask1],sm+sum[mx[i^mask2]]-min_val);
cmin(min_val,sm+sum[mi[i^mask2]]);
sm+=sum[(i+gap-1)^mask2];
}
}
}
int q;read(q);
for(i=1;i<=q;i++){
read(tp1);s^=1<<tp1;
cout<<ans[s]<<endl;
}
return 0;
}
 

常数分析1

我们最开始对 \(a\) 进行了 \(512\) 次乱序扫描,但容易发现一共进行了 \(512\times512\) 次每次扫描的区间大小均为 \(512\times4\) Byte 的扫描,这种方式可以比较好的利用高速缓存,因为被一次 cacheline 读取的 64Byte 数据都被放入了高速缓存并在时间上具有局部性。

注意到第二部分对 sum 计算的前缀和,由于 L3 高速缓存的约能存下 \(2^{18}\) 个 long long 数据,但是我们又存储了 sum,并且在第三部分有对 sum 一些固定位置的随机访问,因此,a 数组就被踢出了高速缓存,再次访问的时候需要重复读取,造成了相当大的浪费。

事实上,我们并不需要存储每一个 sum,每一个块需要存储的数据量是 \(O(1)\) 的,对这个做一个优化,我们得到了一份新的代码。

实现2

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
#include<bits/stdc++.h>
#define y1 y3647
#define INF 1000000000
#define LL long long
#define pii pair<int,int>
using namespace std;
template<typename _type>
inline void read(_type &x){
x=0;int f=1;char ch=getchar();
while(ch!=45&&(ch>'9'||ch<'0'))ch=getchar();
if(ch==45){f=-1,ch=getchar();}
while(ch<='9'&&ch>='0'){x=x*10+ch-48;ch=getchar();}x*=f;
}
template<typename _type1,typename _type2>void cmin(_type1 &a,const _type2 b){if(a>b)a=b;}
template<typename _type1,typename _type2>void cmax(_type1 &a,const _type2 b){if(a<b)a=b;}
const int N=18;
int i,j,k,n,s,t,m,tp1,tp2;
int a[1<<N];
LL mx[1<<N/2],mi[1<<N/2],sum[1<<N/2],ans[1<<N];
signed main()
{
// freopen(".in","r",stdin);
// freopen(".out","w",stdout);
// freopen(".in","w",stdout);
read(n);
for(i=0;i<1<<n;i++)read(a[i]);
int now=0;
for(int mask1=0;mask1<1<<n/2;mask1++){
LL gap=1<<n/2,max_val=0,m=n>>1;
memset(mx,0,sizeof(mx)),memset(mi,0,sizeof(mi));
for(i=0;i<1<<n;i+=gap){
LL sm=0;
for(j=i;j<i+gap;j++){
sm+=a[j^mask1];
if(sm>mx[i>>m])mx[i>>m]=sm;
if(sm<mi[i>>m])mi[i>>m]=sm;
cmax(max_val,sm-mi[i>>m]);
}
sum[i>>m]=sm;
}
for(int mask2=0;mask2<1<<n;mask2+=gap){
ans[mask2^mask1]=max_val;
LL min_val=0,sm=0;
for(i=0;i<1<<n;i+=gap){
cmax(ans[mask2^mask1],sm+mx[(i^mask2)>>m]-min_val);
cmin(min_val,sm+mi[(i^mask2)>>m]);
sm+=sum[(i^mask2)>>m];
}
}
}
int q;read(q);
for(i=1;i<=q;i++){
read(tp1);
s^=1<<tp1;
cout<<ans[s]<<endl;
}
return 0;
}
 

常数分析2

我们将 a 从 long long 改为了 int,提升了 cacheline 读取效率,并只额外存储了 \(512\times3\times8 \text{ Byte}\) 的块信息,这样在以后的计算中,对大数组的随机访问可以变为对小数组的访问,大大提升了高速缓存利用率。

可以通过此题。

Further Explore

继续对代码进行修改,观察其时间变化。

最初代码用时为 1450ms

E1

1
2
3
4
5
6
7
8
LL sm=0;
for(j=i;j<i+gap;j++){
sm+=a[j^mask1];
if(sm>mx[i>>m])mx[i>>m]=sm;
if(sm<mi[i>>m])mi[i>>m]=sm;
cmax(max_val,sm-mi[i>>m]);
}
sum[i>>m]=sm;

改为

1
2
3
4
5
6
7
8
sum[i>>m]=0;
for(j=i;j<i+gap;j++){
sum[i>>m]+=a[j^mask1];
if(sum[i>>m]>mx[i>>m])mx[i>>m]=sum[i>>m];
if(sum[i>>m]<mi[i>>m])mi[i>>m]=sum[i>>m];
cmax(max_val,sum[i>>m]-mi[i>>m]);
}

预期效率降低,原因为全局变量不会放入寄存器。

实际效率未降低,原因推测为 \(O2\) 优化自动使用了该优化。

继续进行本机测试,共 9 次随机数据,运行时间分别为 16339ms 16339ms,符合预期,不开启优化时,全局变量一定不会放入寄存器。

E2

a 数组改为 long long 类型。

预期由于高速缓存溢出,效率下降,实际未发生效率下降,应该是不明高速缓存机制原因。

#defin int long long

预期由于高速缓存溢出,效率下降,64bit 编译器和机子,实际效率有提升,9 组时间分别为 16636ms 16167ms。

开启 O2 后无明显差异,分别为 5577ms 5561ms

32bit 编译器,64bit 机子,O2 效率出现明显下降,分别为 11839ms 14920ms

Conclusion

  • O2 优化后,编译器会自动完成很多代码层面上的优化,我们更需要关注的是算法常数本身
  • 高速缓存的利用情况很大程度决定了代码的效率,编写需要卡常的程序时应该尤为注意,滚动数组能有效提升高速缓存利用率,分块处理减少数组大小也是提升效率的一种可行方案。

从ZKW线段树看线段树的性质

最近遇到了很多线段树性质相关的题目,故在此做一个总结。

常规建树

代码

1
2
3
4
5
6
7
8
9
void build(int l,int r,int rt){
do_something();
if(l==r){
return ;
}
int mid=l+r>>1;
build(l,mid,rt<<1);
build(mid+1,r,rt<<1|1);
}

性质

  • 左儿子长度不小于右儿子。
  • 节点编号 rt 描述了从根到自身的父子关系,也间接描述了该点长度和根节点长度的关系,具体的,根节点的最大或最小长度是一个关于该节点长度的一次函数,这个一次函数只由 rt 决定。
  • 编号最大的节点不一定是 r,事实上可以在 \(\log n\) 的时间内求出,如果左儿子多一层,那么一定在左儿子,否则在右儿子,决定某个儿子是否会多一层,当且仅当目前长度为奇数,且 popcount 值为 2。

例题

一道简单的题

一道比较简单的题

非常规建树

非常规建树一般会指定建树的 mid 位置。

区间覆盖数

即覆盖一个区间 \([l,r]\) 的最小线段数。

先转成 \((l,r)\),然后依次跳叶节点 \(l,r\) 的父亲,先判断 \(l,r\) 的父亲是否相同,相同就可以走人了。

如果 \(l\) 作为左儿子跳上去,那么该节点的右儿子会对该区间贡献一次,因为该节点的右儿子的父亲超出了区间,但自身在区间内。如果 \(r\) 作为右儿子跳上去,那么该节点的左儿子会对区间贡献一次,原因同理,如此就可以找到区间覆盖数,这也是 ZKW线段树 的原理。

例题

给定一个指定 mid 节点的线段树,需要支持 rotate 一个节点,rotate 定义为伸展树(splay)的 rotate,强制在线询问区间覆盖数。

先考虑没有修改,那么就是找到 \(l,r\) 的 \(lca\),然后一路统计 \(l\),\(r\) 作为左右儿子的次数即可,可以用倍增快速解决。

修改本质上就是断边和加边,用 LCT 维护。

ZKW线段树简介

建树

为了方便,需要建一棵有 \(2^k\) 个节点的树,主要是为了让高度相同,求出第一个不小于 \(n\) 的 \(2\) 的次幂的方式:k=32-__builtin_clz(n-1)。

建树时注意没有数据的地方应该弄成 "0",且注意初始数组大小,并且要开 \(2^k+5\) 以免溢出。

建树时记录单点的编号。

单点修改

直接从下往上改就可以了。

1
2
3
void update(int rt,int c){
a[rt].mx1=c;while(rt!=1)push_up(rt>>=1);
}

区间查询

个人习惯闭区间,且有效区间落在 \([1,n]\)。

查询时看是否为兄弟节点,如果是就停下,否则对于左端点,是左子树则加上兄弟右子树。对于右端点,是右子树则加上兄弟左子树。另外需要加上两个端点。

1
2
3
4
5
6
7
8
9
10
node query(int lrt,int rrt){
if(lrt==rrt)return a[lrt];
node ret=a[lrt]+a[rrt];
while(lrt>>1!=rrt>>1){
if(~lrt&1)ret=ret+a[lrt+1];
if(rrt&1)ret=ret+a[rrt-1];
lrt>>=1,rrt>>=1;
}
return ret;
}

注意特判区间长度为 \(1\) 的情况。

区间修改

由于是从下往上查询,所以只能采用标记永久化的方式,像查询那样做修改,在对应的点上打 Tag。

效率

对于 \(10^5,3\times 10^5,10^6\) 的随机数据进行了测试,效率改进因子约为 \(0.4\)。

简单数论函数和应用

参考资料

部分定义和约定

符号

  • \(\operatorname{id}\) :\(\operatorname{id}\) 数论函数,\(\operatorname{id}(x)=x\)
  • \(\epsilon\) : 单位函数 \(\epsilon(x)=[x=1]\)
  • \([]\) :中扩号表达式,中扩号内条件成立则为 \(1\),否则为 \(0\)
  • \(\boldsymbol{1}\):\(\boldsymbol{1}\) 函数,若 \(f(n)=\boldsymbol{1}\),则 \(\forall x \in N^+,f(x)=1\)

数论函数

  • 一个数论函数定义域为正整数,值域为复数。

  • 一个数论函数为积性函数,当且仅当 \(\forall (a,b),\gcd(a,b)=1\rightarrow f(a\times b)=f(a)\times f(b)\)

  • 一个数论函数为完全积性函数,当且仅当 \(\forall a,b,f(a\times b)=f(a)\times f(b)\)

迪利克雷卷积

迪利克雷卷积为数论函数的乘法操作,定义两个数论函数的迪利克雷卷积定义为 \[ g=f*h,g(n)=\sum\limits_{d|n} f(d)\times h(\frac{n}{d}) \]

迪利克雷卷积的除法操作就是逆操作,一般只能构造得到。

迪利克雷卷积的性质(证明见下一部分):

  • 两个积性函数的迪利克雷卷积仍是积性函数。
  • 两个积性函数的迪利克雷卷积除法结果仍是积性函数。

为了方便,以下所有数论函数的乘法未经说明均为迪利克雷卷积。

常见积性函数

  • 欧拉函数 \(\phi(n)\)
  • 莫比乌斯函数 \(\mu(n)\)
  • 约数个数函数 \(d(n)\)

一些结论的简单证明

迪利克雷卷积的性质

简单性质

  • 积性函数 \(f\),满足 \(f(1)=1\)

逆元存在且唯一

所有数论函数存在逆元,即对于所有 \(f\),存在 \(g\) 使得 \(f*g=\epsilon\),直接构造对应的 \(g(n)\) 即可。 \[ g(n)=-\dfrac{\sum\limits_{d|n,d\neq n}{f(d)\times g(\frac{n}{d})}}{f(1)}\\ g(1)=\frac{1}{f(1)} \] 因此数论函数的逆元存在且唯一。

交换律

\(f * g=g * f\),显然成立

结合律

\(f * g * h=f * (g * h)\),成立,但不显然。

令 \(f * g * h=f_1,f * (g * h)=f_2,f * g=a,g * h=h * g=b\) \[ f_1(n)=\sum\limits_{d_1|n} a(d_1)\times h(\frac{n}{d_1})=\sum\limits_{d_1|n}\sum\limits_{d_2|d_1} f(d_2)\times g(\frac{d_1}{d_2})\times h(\frac{n}{d_1}) \]

\[ f_2(n)=\sum\limits_{d_1|n} b(d_1)\times f(\frac{n}{d_1})=\sum\limits_{d_1|n}\sum\limits_{d_2|d_1} h(d_2)\times g(\frac{d_1}{d_2})\times f(\frac{n}{d_1}) \] 对于任意一组满足 \(d_1|n,d_2|d_1\) 的 \(d_1,d_2\),构造 \(d_2'=\frac{n}{d_1},d_1'=\frac{n}{d_2}\) ,容易发现这样的构造是一一对应的,满足 \(f(d_2)\times g(\frac{d_1}{d_2})\times (\frac{n}{d_1})=f(\frac{n}{d_1'}) \times g(\frac{d_1'}{d_2'}) \times h(d_2'))\) 。

因此对于上式中的每一项,下式都有一项与之一一对应,因此上下式相等。

分配律

\(f*(g+h)=f*g+f*h\)

显然成立。

两个积性函数的迪利克雷卷积为积性函数

\(f,h\) 为积性函数,则 \(f*g=h\),\(h\) 为积性函数。

\(\forall a,b \ , \gcd(a,b)=1\ ,h(a\times b)=h(a)\times h(b)\),满足 \[ \begin{align} h(a\times b)=&\sum\limits_{d_1|a}\sum\limits_{d_2|b}f(d_1\times \frac{b}{d_2})\times g(\frac{a}{d_1}\times d_2)\\ =&\sum\limits_{d_1|a}\sum\limits_{d_2|b}f(d_1)\times f(\frac{b}{d_2})\times g(\frac{a}{d_1})\times g( d_2)\\ =&\sum\limits_{d_1|a} f(d_1)\times g(\frac{a}{d_1})\sum\limits_{d_2|b} f(\frac{b}{d_2})\times g(d_2)\\ =&h(a)\times h(b) \end{align} \]

两个积性函数的迪利克雷卷积除法为积性函数

证明 \(f,h\) 为积性函数,且 \(h*g=f\),则 \(g\) 为积性函数。

令 \(h'*h=\epsilon\),则 \(g=f*h'\)

即证明积性函数的逆元也为积性函数。

证明

使用了数学归纳法。

完全积性函数相关

若 \(w\) 是完全积性函数,则 \[ (g\cdot w) * (f \cdot w) = (g * f)\cdot w \]

常见的积性函数关系

  • \(\mu* \boldsymbol{1}=\epsilon\)
  • \(\phi* \boldsymbol{1}=\operatorname{id}\)
  • \(\mu * \operatorname{id} = \phi\)

莫比乌斯反演

莫比乌斯反演的常见做法是用其它易于交换求和符号的项替换掉不容易求和的相关项。

不容易交换求和的项一般有 \(d,\gcd\) 等。

数论分块

莫比乌斯反演或者其它数数题中常用的优化方式。

核心原理是对于 \([1,n]\) 中所有数 \(i\),\(\frac{n}{i}\) 的结果只有 \(\sqrt{n}\) 个。

证明是容易的,对于 \([1,\sqrt{n}]\),一共有 \(\sqrt{n}\) 个值,对于 \([\sqrt{n},n]\),一共也只有 \(\sqrt{n}\) 个值。

枚举的方式是先枚举一个 \(l\),然后计算出一个最大的 \(r\),满足 \(\frac{n}{r}=\frac{n}{l}\),容易证明 \(r=\big\lfloor\dfrac{n}{\lfloor\frac{n}{l}\rfloor}\big\rfloor\)。

1
2
3
for(int l=1,r=1;l<=n;l=r+1,r=n/(n/l)){
do_something();
}

莫比乌斯函数

定义

\[ \mu(n)= \begin{cases} 1&n=1\\ 0&n\text{ 含有平方因子}\\ (-1)^k&k\text{ 为 }n\text{ 的本质不同质因子个数}\\ \end{cases} \]

\(\mu*\boldsymbol{1}=\epsilon\)

这是核心结论了。

考虑证明 \(\forall n>1,\mu(n)=0\)。

考虑每个约数的贡献,显然每个质因子只需要考虑一次,如果质因子出现多次,那么根据定义贡献为 \(0\)。

设有 \(k\) 个质因子,那么选出奇数个和选出偶数个的方案显然是相等的,所以和为 \(0\)。

莫比乌斯反演

一般形式

\[ \begin{align} f*\bold{1}=g\iff& g*\mu=f \\ g(n)=\sum\limits_{d|n}f(d)\iff& f(n)=\sum\limits_{d|n}\mu(d)\times g(\frac{n}{d}) \end{align} \]

证明是显然的,因为 \(\boldsymbol{1}*\mu=\epsilon\)

常用

\([\gcd(i,j)=1]=\sum\limits_{d|\gcd(i,j)}\mu(d)\)

枚举 \(d\),即可快速计算。

欧拉反演

名字是杰哥取的。

常用形式

\(\gcd(i,j)=\sum\limits_{d|\gcd(i,j)}\phi(d)\)

证明

即证明 \(\phi*\boldsymbol{1}=\operatorname{id}\) 。

我们只需要证明 \(\phi*\boldsymbol{1}\) 在 \(p^c\) 处取值为 \(\operatorname{id}(p^c)\),由于 \(\phi,\boldsymbol{1},\operatorname{id}\) 均为积性函数,自然在所有位置成立。 \[ \begin{align} (\phi*\boldsymbol{1})(p^c)=&1+\sum _{i=1}^{c} (p-1)\times p^{i-1}\\ =& 1+\frac{p^c-1}{p-1}\times(p-1)\\ =&p^c\\ =&\operatorname{id}(p^c) \end{align} \]

筛法

介绍四大筛法。

四大筛法通常用于求一些积性函数的前缀和。

假设要求 \(f\) 的前缀和。

记 \(F(n) = \sum\limits_{i=1}^n f(i),H(n)=\sum\limits_{i=1}^n h(i),G(n)=\sum\limits_{i=1}^n g(i)\)。

杜教筛

杜教筛的核心是构造两个容易求前缀和的函数 \(g,h\),满足 \(h = f * g\)。

有 \[ \begin{align} H(n)&=\sum\limits_{i=1}^n h(i)\\ &=\sum_{i=1}^n\sum_{d|i}g(d)f(\frac{i}{d})\\ &=\sum_{d=1}^ng(d)\sum_{i=1}^{\lfloor\frac{n}{d}\rfloor} f(i) \end{align} \] 将右边 \(d\ge 2\) 的项移到左边 \[ H(n)-\sum\limits_{d=2}^ng(d)F(\lfloor\frac{n}{d}\rfloor)=F(n)g(1) \] \(H(n)\) 是好求的,然后 \(g(1)=1\),后面的项对 \(n\) 数论分块。

然后有一个结论 \(\big\lfloor\dfrac{\lfloor\frac{n}{a}\rfloor}{b}\big\rfloor=\lfloor\dfrac{n}{ab}\rfloor\)。因此要求的项只有 \(\sqrt n\) 项。

线性筛前 \(n^\frac{2}{3}\) 项的前缀和,可以取到最优复杂度 \(n^\frac{2}{3}\)。复杂度证明见 OI-WIKI,证明。

PN(Powerful Number) 筛

定义 Powerful Number 是每个质因数质数不小于 \(2\) 的数。

如果能构造一个容易求前缀和的积性函数 \(g(x)\),满足 \(g(p)=f(p)\),那么我们就可以在 \(O(\sqrt n)\) 的时间复杂度内计算 \(F(n)\)。

具体的,考虑构造 \(h = f / g\),所以 \(f(p) = h(1)g(p) + h(p)g(1)\),由于 \(g(p) =f (p)\),所以有 \(h(p)\) 处取值为 \(0\),由于 \(g,f,h\) 都是积性函数,所以 \(h\) 仅在 Powerful Number 处有取值,其余处取值为 \(0\)。

考虑 \[ \begin{align} F(n)&=\sum_{i=1}^nf(i)\\ &=\sum_{i=1}^n\sum_{d|i}h(d)g(\frac{i}{d})\\ &=\sum_{d=1}^nh(d)\sum_{i=1}^{\lfloor\frac{n}{d}\rfloor}g(i) \end{align} \] 枚举所有 Powerful Number,计算 \(h(d)G(\lfloor\frac{n}{d}\rfloor)\) 即可,Powerful Number 的个数是 \(O(\sqrt n)\) 的。

构造 \(h\) 的话,可以直接用 \(g * h = f\),并使用卷积的定义构造,当然,\(f(p^c)\) 必须要容易求。

州阁筛
0%