漫谈基模
年轻人随便写写。
大就是好
大模型的灵性,进而给人的震撼感是难以想象的。
灵性是 "在信息不完整时提出正确假设的命中率","长上下文中保持意图一致性的程度"
一些看起来理应做成多阶段的任务,更大模型可以直接 oneshot 完成。
在有些实际业务场景 7B 和 300B 在跑分上的差距几乎可以忽略不计,但实际上往往是评测的难度,甚至是业务的难度限制了大模型的发挥空间,或者说很多业务根本不需要那么大的模型。我测试后者的时候甚至有点核弹眩晕瘫坐的感受,难以想象这真的是能 oneshot 端到端做的非常漂亮的任务。
另一个影响灵性的因素是训练数据质量
MiMoV2.6 发布之前,我试用过两周(用于真实生产任务),我给的最大的反馈就是:整体完成任务的能力和 opus5 相差无几,但能明显感受到灵性远不如 opus5。
什么是灵性,举个例子,面对某些 bug,opus5 将周边代码上下文装载进去后直接意识到了错误,v2.6-pro 组织了实验,抓去日志并将错误分析了出来。
另外我认为 opus5>opus4.6>opus4.8>opus4.7,Musk 爆料说 opus4.6 是 5T 的,业内有传闻说是 opus4.8 和 opus4.7 都在规模上缩水了,opus5 恢复了 opus4.6 的规模。我使用中就明显感觉到较小的模型,以至于实际体感不如 opus4.6。
现在(2026.10.31)比较常用的 frontier-models 有 opus5.5,6astra 和 6.1sol,先说 astra,我是从 opus5 换到 astra 的,opus5 一个非常大的毛病就是喜欢瞎写注释,代码注释,文档里过度辩护,考古,过度解释。我觉得这种行为是污染上下文,非常不利于长期维护。
用上 astra 之后感觉这个毛病少了不少,astra 整体的灵性相较于 opus5 还更胜一筹。但是 astra 行事非常保守(可能和数学方面的训练有关),走一步验证三步,实际上大部分工作连一步的验证都不需要。另一个很震撼的点就是 computer use for daily work 的能力,查资料报表这种,做旅游攻略,真的能有效落实到生活助手上。不过我试了试用 astra+gemini 做 l2d,失败了,这个关键能力瓶颈确实没跨过去。
opus5.5 可能是我用过的体验最好的模型,不亚于我第一次从 cursor 的 composer 换成 opus4.5 的那种飞跃质变体验。它真正能从我的 CLAUDE.md 和我提示词风格,repo 组织方案,上下文布局方案里理解我的 taste,有一点相见恨晚的感觉。往往是我等它工作的时候输入 prompt,才发现它给我的简报中已经说明它已经处理好我 prompt 中提到的潜在问题。过度辩护、过度解释的毛病都没了,考古也克制很多,并且已经可以用提示词压住考古,它考古的内容都是真的后续潜在有用的。相比 astra 的又一个飞跃。
唯一的缺点是我的大部分工作会被 frontier-llm 到 opus5 去。
我还没试过用用 opus5.5 做视频,看网上的 case 确实很震撼。
6.1sol 感觉定位有点像个大号 deepseek,或者我感觉它的能力可能和即将发布的 deepseek-v4.1-pro 接近,它的灵性相比 astra 和 opus5.5 弱了太多,但是基本的许愿式编程,运维这些能力都还过得去。优秀的牛马模型,能get work done。但是在整体大局观上和前两位差距不小。
灵性好和干活靠谱其实不算一种能力,后者主要还是靠后训练上去,知道什么时候该干什么,灵性更像是智力。绝对部分的日常工作不需要太高的智力。有点像一个顶尖的竞赛选手来下围棋,他即使简单学习一段时间也大概率下不过普通的爱好者。
DeepSeek-v4.1-Flash,MiMo-2.6-Pro 就是那个爱好者。能干活,但是交流起来明显感觉智力和顶级模型有差距。
Fable5 用过一段时间(frontier-llm 很头疼),Fable5.1 没关注过。
为什么做基模
要回答“你们小米做基模干什么?”
先考虑基模可以用来干什么?
首先可以用来工作,ClaudeCode,Codex Desktop,WorkBuddy,协助人类完成日常工作(不只是开发)
其次可以用来嵌入到业务中,这个问题在知乎的 "qwen3-0.6B 这种小模型有什么实际意义和用途吗?",有非常详尽的解答。
最后,基模是下一代产业的工业母机。
谈到工业母机的问题,要先聊一下所谓全模态。
人类现有获知信息的手段,有且仅有各种形态的传感器。
我理解的全模态不局限于听觉和视觉,而应该是对广义的波形信号都能有理解。
举例来说:
- 一维波形 \(s(t)\),例如温度压力。
- 多通道一维波形 \(\bold{s}(t)=[s_1(t),s_2(t),…,s_C(t)]\),例如麦克风阵列,三轴磁力计。
- 波形场 \(P(x,y,t)\),例如热成像。
早在 StableDiffusion 阶段,图片理解能力对图片生成能力的促进作用就初见端倪。这些更广阔的模态能力很可能有巨大的潜力可以发掘。
现在,合成数据已经大规模的加入到了基模的训练中,而基模又可以合成数据,也就是其实可以用基模来改进基模(当然离不开人类少量参与在整个过程中加以监督,例如系统性验证数据质量)。
在上面这些全模态数据上做好充分训练后,在下游制造业,就有难以想象的应用空间了(制造业流程的数据也就上面提到的那些)。
深度学习技术早已工业化成熟,大量场景现在做不到自动化数字化本质是缺少数据,真正的全模态基模一个重要用途就是辅助合成下游数据。
甚至与 AGI 结合,把从合成数据到产出工业软件的流程也能大幅简化。
工业场景的核心壁垒是场景碎片化。
如果有一个能初步理解工业数据的基模,结合成熟的深度学习方案,少量专业行业人员往往就可以把这个门类所需的大量工业软件实现出来。
我认为 astra 和 opus5.5 是 AGI。
所谓工业化其实就是有稳定的 SOP 操作流程,人本身也是流程的一部分,AGI 只是一定程度把人替代掉。
为什么只有开源模型,或者只有基模而没有训练它的团队是不够的(训好了把人全开了)?
至少在目前看来,一个真正意义上的基模团队才能协助下游工业的专家们理解好大模型在这些领域的想象空间。
生成理解统一,训练基模的过程也是理解基模能力边界的过程,是 Know How,Know Why 的过程。基模团队才能测绘好模型的能力边界。
RSI 也好,下游工业化也好,没有基模团队的参与,是很难跑通的。
小米集团本身有充分的下游制造业支撑,大模型 For 制造业这个流转过程很可能在小米这里首先完成。
基模为什么能 Work 至今没人讲得明白,我说的 How 和 Why 都是更具体的一些问题。
Agent 自进化尝试
闲聊一些实践感受。
我觉得这个是在 opus5.5 出来之后才是一个性价比足够高的尝试(astra 勉强能跑通但是我没啥感觉),其实这个也和灵性有关。
其实核心也就 2 个 SKILL,自我反思(reflect),工作区资产整理(consolidate)。配套一些 harness,用于辅助抽取会话内容,工具调用内容。
自我反思的流程主要是强模型对前一段时间的会话进行审视,检查其中的 trial and error,以及过长的流程,前者更新或者引入 SKILL,后者改进工作基础设施,基本都是自动完成并自动验收,初步看上去效果不错。
工作区资产整理的流程就是对之前调试运行或者性能优化,特性实现过程中产出的目录进行整理,归纳知识性和方向性事实性的结论,下次类似工作时省略重复探索,另外就是保持工作区作为上下文环境的干净。
说到这里,人一定要多用 frontier-models,多探索和了解前沿的新质生产力。
训推计算流梳理
推理计算流梳理
基本计算
Norm&Residual
采用 Pre-Norm,RMSNorm。 \[ U_\ell=\operatorname{RMSNorm}_{\ell,\mathrm{attn}}(X_\ell),\qquad R_\ell=X_\ell+\operatorname{Attention}_\ell(U_\ell) \]
\[ V_\ell=\operatorname{RMSNorm}_{\ell,\mathrm{ffn}}(R_\ell),\qquad X_{\ell+1}=R_\ell+\operatorname{FFN}_\ell(V_\ell) \]
\(\gamma_j\) 是可学习的量。 \[ \operatorname{RMSNorm}(x)_j=\gamma_j\frac{x_j}{\sqrt{\frac{1}{4096}\sum_{k=0}^{4095}x_k^2+10^{-5}}} \]
RoPE
对于一个向量,通常会将其中一部分标量两两绑定,对两两绑定的标量做 RoPE。
一个例子是对于 dim=192,约定将前 64 的位置按照
(i, i+32) 为一组绑定,对这些位置应用 RoPE 旋转。 \[
R(\theta)=\begin{bmatrix}\cos\theta&-\sin\theta\\\sin\theta&\cos\theta\end{bmatrix},\qquad\begin{bmatrix}u'\\v'\end{bmatrix}=R(\theta)\begin{bmatrix}u\\v\end{bmatrix}
\]
通信原语
| 原语 | 输入与输出关系 | 典型使用位置 |
|---|---|---|
| All-Reduce | 各 rank 的相同形状张量逐元素归约,完整结果分发给各 rank | 汇总 Row Parallel 的部分和 |
| All-Gather | 拼接各 rank 的分片,完整结果分发给各 rank | 重建 token 或特征维度 |
| Reduce-Scatter | 先归约,再让每个 rank 只保留结果的一片 | 为下一阶段建立 token 分片布局 |
| All-to-All | 每个 rank 将不同数据发送给不同目标 rank | MoE token dispatch/combine |
张量并行和通信
设一批 token 的 hidden 为 \(X\in \mathbb{R}^{m\times d}\),线性层为 \(W\in \mathbb{R}^{d\times f}\),输出为 \(Y=XW\)。
通常用一个行向量代表一个 token 的信息,每一列是不同的特征量
列并行
拆权重的列(输出维),如果下一步需要完整的 \(Y\),可以做 All-Gather。 \[ W=[W_0\;W_1\;\cdots\;W_{p-1}],\qquad Y_i=XW_i \]
行并行
拆输入的列和输出的行,每个输出 \(X_iW_i\) 有完整形状但是只有和的一部分,后续一般要做和 Reduce 有关的操作以便处理。 \[ X=[X_0\;X_1\;\cdots\;X_{p-1}],\qquad W=\begin{bmatrix}W_0\\W_1\\\vdots\\W_{p-1}\end{bmatrix} \]
\[ Y=\sum_{i=0}^{p-1}X_iW_i \]
实际 MLP 计算策略
MiMo-V2.5 使用这样的门控 MLP。 \[ Y=\left(\operatorname{SiLU}(XW_{\mathrm{gate}})\odot XW_{\mathrm{up}}\right)W_{\mathrm{down}} \] 对于 \(W_\text{gate}, W_\text{up}\),采用列并行,\(\text{SiLU}\) 和 pointwise 的计算无需通信。
此时每个 rank 持有一份分片,恰好是行并行要求的 \(X\) 分片方式,对 \(W_\text{down}\) 做行并行,可以得到最终计算结果。
Attention 的切分
Attention 通常按照 heads 切分。
对于 GQA 的 attention,通常 Q 比 KV 会多,如果
world_size=8,kv_heads=4,通常需要将 KV
复制一份,按列硬拆会在 SPDA 过程引入额外的通信(需要获取别的 rank 上的
KV)。
正常 Attention 过程中,先复制分发 hidden stats,各个 Rank 计算自身的 QKV,独立完成自己负责的 attention,在输出投影 \(W_O\) 后可以得到部分和,此时做一次 All-Reduce。
专家并行
MoE Router 过程
使用一层 \(\text{sigmoid}\) 激活带偏置的神经网络对 Expert 做打分,取 Top8,并分配权重。注意偏置不参与权重分配打分。 \[ z=xW_r^{\mathsf T},\quad s=\operatorname{sigmoid}(z),\quad I=\operatorname{Top8}(s+b)\qquad w_i=\frac{s_i}{\sum_{j\in I}s_j}\;(i\in I) \]
EP 路径
实际的实现中,Attention 的 All-Reduce 变成了 Reduce-Scatter,每个 rank 都持有一定量 token 和 \(W_r\),计算之后,做 All2All dispatch 通信。
dispatch 后每个 rank 各自做 MLP 计算(无通信)。MLP 计算需要单个 rank 激活多个专家,可以使用 grouped GEMM 统一调度计算。
MLP 结束后,某种实现是在来源 rank 做加权求和得到最终状态。
MiMo-V2.5 大致计算路径
- token_id 发到每个 rank,查表(不在表中的置零),All-Reduce。
- Input Pre-Norm; attention; post-attention Norm; SiLU MLP
训练计算流梳理
上下文并行
实际训练时,例如一条 256k 的序列,为了反向传播计算梯度,前向激活必须保留,attention 层输出的内容如果不切分保留。一层的激活大约 \(2^{12} \times 2^{18} \times 2 \text{Byte}=2\text{GiB}\)。
正常算 Attention 的 \(W_O\) 时,每张卡得到部分和,做完后会做 All-Reduce,每张卡都会保留 \(2\text{GiB}\)。
48 层会撑爆。
上下文并行让一个 CP 组的不同 rank 负责不同部分的 Attention 计算,一方面分摊计算量,一方面让每张卡保留的激活值减小。
SPDA 需要其他 CP rank 的 KV,因此有通信。
序列并行
一般来说 SP=TP。
例如 SP=TP=4 的时候,Attention 完成后,对一个 TP 组,所负责的序列部分,激活着在每个 TP rank 上都有一份拷贝。
开启序列并行时,每个 rank 只保留一部分激活值,无重复保存。
ulyseses 计算过程
对于一个 CPxTP 组,计算 Attention 时,发生通信,让每个 rank 持有更少的 head 和完整的序列。
对于 kv head,复制若干份,对于 q head,保留一份,因此通常 CPxTP 的大小不会超过 qheads。
例如 qheads=64, kvheads=4,CP=16,TP=4 时,每个 rank 持有一个 q head,一个 kv head 复制 16 份给到对应 rank。
SWA 的计算直接用 Halo Exchange,通信量少,朴素实现
重新思考底层知识
最近在上 CSAPP 的第三部分课程,讲了不少网络(尤其是 socket 有关协议)的底层知识。
实验作业是实现一个 proxy lab,逻辑上不算难,我最初想尝试一下纯手搓,但之后选择了放弃。
最大的阻碍是了解接口细节和一些隐式知识(例如 csapp.h)的过程花费了太多时间。
自 Claude-opus-4.5 发布以来,AI 的综合能力已经有了质的飞跃,让一个 opus 水平的模型来完成这个实验,5 分钟足够。
了解底层知识是否需要完全亲自动手接触每一个细节的实践?
我觉得接口、契约细节本身并不值得花费时间和精力去记。比较值得学习的应该是阅读过程中产生的一些 no sense,而这种 no sense 需要从 “设计哲学” 出发去思考,重新走一下前辈们的老路。
例如提到 "监听套接字" 和 "连接套接字"。
- 为什么要特意去分监听和连接,是否引入了不必要的复杂性。
- 一个端口通常和一个进程绑定,之前提到的 fork 创建新进程处理连接套接字和这里我的理解冲突。
进一步发散思考后,其实有以下认知矫正:
一个套接字的描述符文件是 (clienthost, clientport, serverhost, serverport) 四元组,不同四元组是独立文件。(通常对服务器来说,每个连接套接字的 clienthost,clientport 是不同的,天然可以也应该做区分)
socket 是文件,读写是阻塞的,如果不区分监听和连接那么监听的端口,那么理论上就不可能做到一个端口服务多个客户端。(这里有一个鸡生蛋的悖论,四元组设计和这个思考矛盾了)
每个人的背景知识不一致,对于一个新的信息源,有效的利用方式是对照自己的思考模式,找到 no sense,并深入思考。
第一遍的阅读往往具有很大信息量,走到下一个阶段时,重新阅读也可以带来一些 no sense 和认知矫正。
至于掌控一个底层知识,我觉得更应该做的就是在生产环境中实践——能用到的自然加深理解,用不到的也没有必要掌握。
经典值得读就是因为在每个阶段去读它一遍。
阅读时能够切实纠正已有误区的 no sense,一般叫做 alpha 信息,alpha 信息越多的文本,通常价值越高,就像强化学习中的 badcase。
如果没有 no sense,另一个值得记下的应该是 highlights,highlights 通常是一些精炼的总结、跨 domain 的类比,相比于 no sense,highlights 对读者来说是正确的,但是需要一些进一步的推导才能导出。
而正确的废话是没有价值的。
我想起来一个链路:从数据到信息,从信息到知识,从知识到智慧。
智慧也许指的是对知识本身的抽象,或者是对获取知识过程的认知和总结,算是一种元学习能力。
星星
去过结构竞赛,看着他们很顺利的完成了五十一块的加载。
把模型拿到了237,在怂恿和撺掇下蒜蓉姐姐先坐了上去,没事。然后我们依次轮流坐上去,看上去都挺结实(其实是坐的比较谨慎)
我看了下幽默的RL训练作业,很一般,然后开始练琴。
双手合奏还是太难了,我单手其实也没弹熟练,往后又练了几段。
看蒜蓉对着PPT学数据结构,一个快速排序看了可能一个小时。(真感觉蒜蓉有时候好笨,不过可能是一边在想别的事一边学)
后面闲着没事干,就拿白板笔过来直接讲了。
隔壁131那块白板不是很方便,但是好在有玻璃,我在玻璃上画图示,讲了shell sort,quick sort和逆序对计数。
最开始比较蠢画到磨砂面了,死活擦不掉,后面就在光滑面画。
我一直比较喜欢用黑板/白板讲课,以至于机构录我讲课视频的时候必须得架一个摄像头。
之前在世贸培训的时候白板笔很难写出水,不过去年再去世贸的时候已经人去楼空了,号爸换地方了。
我说我要买个白板放在237专门用来讲课(其实更早,是我讲软件架构的时候就想买了)
带着蒜蓉和tr姐姐去橘园吃饭,随便扒拉了点。他们还要回牌区。我就想要不先送他们回去了。
他们说都行,我记得蒜蓉和我穿过大草坪的时候她说过想躺在草坪上看星星。237又恰好有上次拔尖班团建留下来的野餐垫,正合适。
蒜蓉说237像个天堂一样。某种意义上还真是。我也好,何老师也好,我们积极建设俱乐部某种意义上就是为了能够有这样一个避风港。
夜色爬上天幕,我从柜子里拿出两张野餐垫,抱着彭彭的抱枕,带他俩去大草坪。一时甚至忘了带手机。
草坪上有射灯,但中央还是很黑。我们铺开野餐垫,躺了上去。
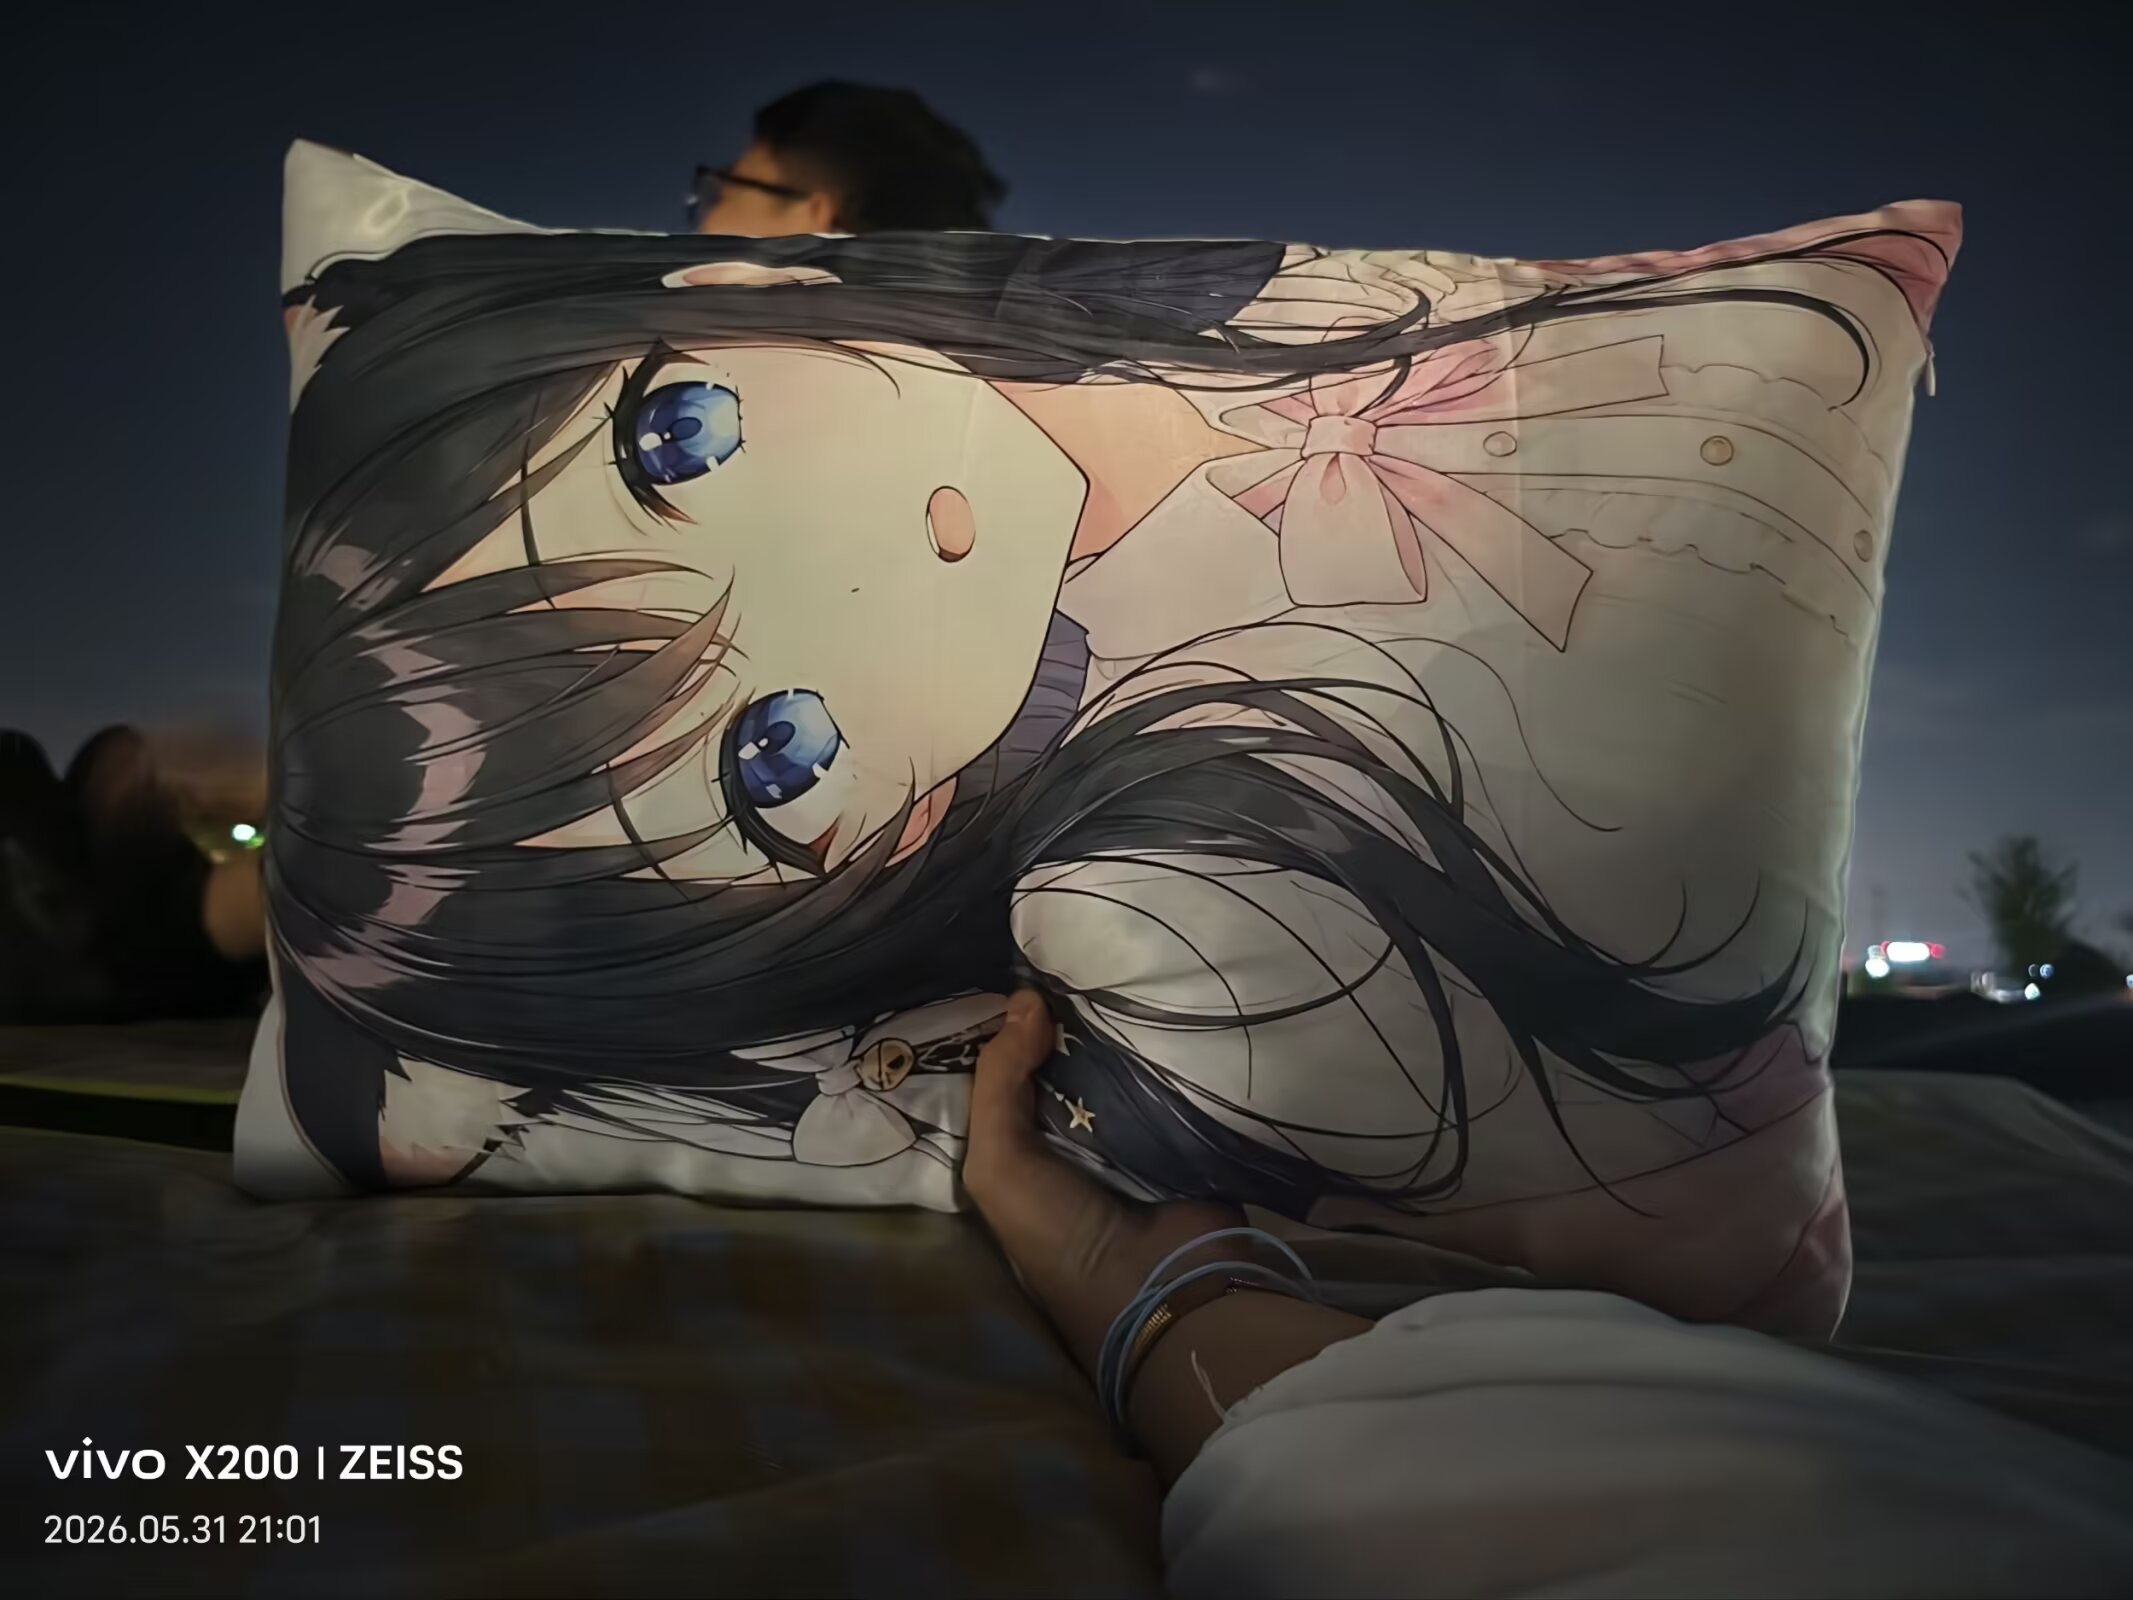
身后是宏伟的图书馆建筑。中午我们来237是穿过图书馆过去的——不然要绕好大一圈。何意魏有给杜老师拍过一张很有名的照片,应该是我们大一那会儿,空旷的前野,飘渺的卷云,像是世界末日前夕一般的构图。又有点像世末歌者的曲绘。
侧身望去,有两颗星星在夜空中很是显眼。蒜蓉说大的那颗是金星,小的那颗是木星。
我第一次知道原来太阳系的行星在地球上是肉眼可见的。
很奇妙的感觉。我的知识储备当然能让我推导出太阳照射在行星上的反光能让它可见,不过用肉眼实际看到又是另一回事。
我还第一次得知了我们所说的"启明星"就是金星。
金星的大气环境很恶劣(玩MC星空模组的时候,登陆金星需要最高等级的防护装备,永备基地需要大量的生命支持设备,我很期待GC模组出5),但人们竟冠之以启明星的称谓。
我们聊到了光污染,城市的光污染其实是光在大气层中反射,让夜空的背景光强很强,以至于星等弱一点的恒星在背景中隐去了。
远处传来演唱会的音乐声,歌明明很熟悉听过很多次,但我就是不知道它叫什么名字。
蒜蓉跟着哼唱起来。
我打开手机放起了"寻遍星空",我很喜欢这首歌,甚至用它的一句歌词做我的签名。至于我和它的缘分是另一个故事。
一曲作罢,我放起了"像小时候一样",一边看星星一边哼唱。
人的肉眼大抵也是有曝光时长的说法的,我盯着云朵空隙的那边暗蓝色,逐渐有了微弱的光点。
换成了busic,"错位时空",相比于原版,我更喜欢五四版的错位时空(其实是被一个群星的快剪和配乐吸引上的),蒜蓉说我和她歌单相似度很高。
我抱着彭彭抱枕在野餐垫上翻来翻去,惊觉金智楼顶上挂着的月亮格外的圆。掏出手机拍照,又一次觉得这手机该换了。
蒜蓉用她的手机拍了照发给我们。
一看日期,农历四月十五。
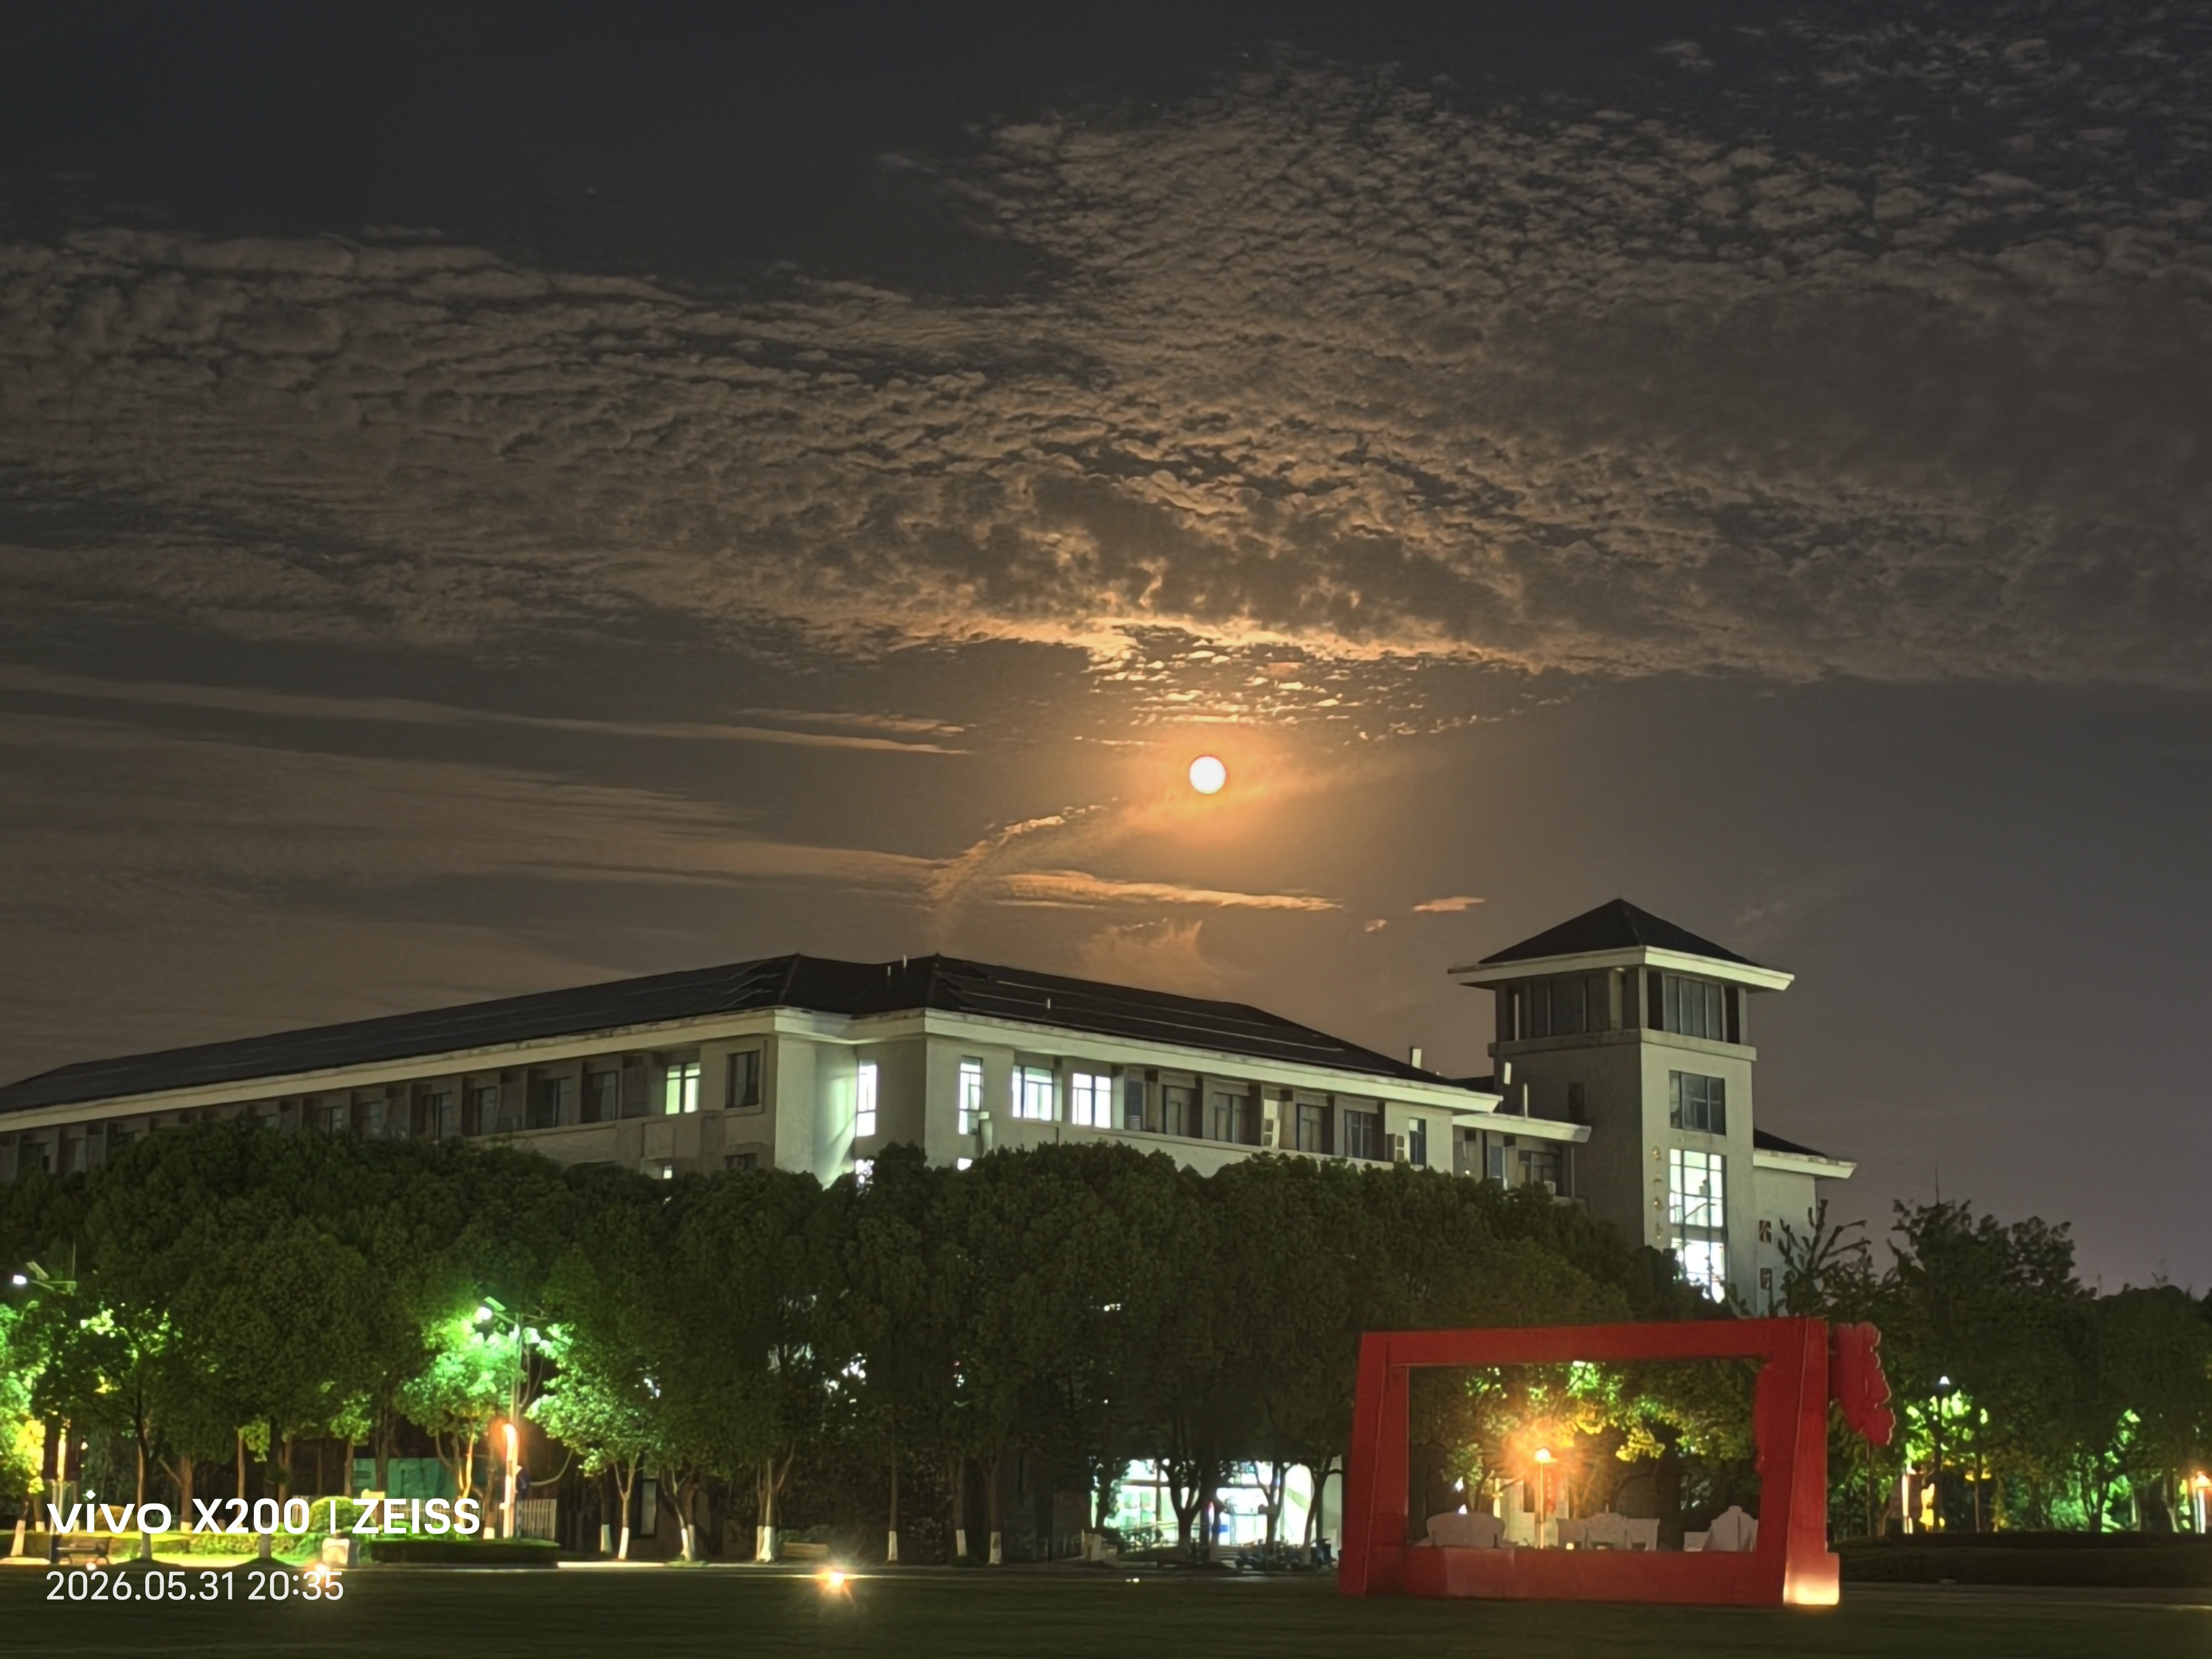
莫名的有点想家,尤其是想外婆。听母亲说她最近又住了一次院。
我不知道我们的缘分还有几年。
我给蒜蓉说过我这个人其实很怕死,所以不想出国什么什么的。我其实很认同可能不久的将来,AI的发展会极大推动科技进步,以至于人均寿命的增速第一次能够跑赢时间,每个人都能有充分的机会去探索这个世界。
父亲也说过,他觉得,可能他都能看到共产主义社会来临。
回过头来,蒜蓉说她也想要个抱枕晚上能抱着睡觉,然后我记住了。
最后,三个人趴在一起,拍了张照片,道了再见。
GPU 推理调优经验
调优经验
核心还是打实际的 Profile 数据,耗时和显存都是。
意识到问题,合理选择 AI 的方案就行。
显存相关
动态分配显存的 fragmentation 问题比较严重,尽量还是用手写 Pool 的方案,更稳定。
CUDA graph
关于动态 shape(主要是不同 batch_size),一般是采用捕获多个 graph,共享预分配显存池,然后请求做 Padding。
由于现代硬件关于 zero padding 有稀疏算力处理,所以性能退化不严重。
捕获的时候会定死执行路径(分支,循环步数之类的),重放的时候必须一致。
速度相关
基本方案
- CUDA graph + torch.compile
- 攒调度的 Batch,通常 Batch 越大平均开销越低。
进阶方案
- 找找有没有 CPU bound 之类的优化掉,比如零碎的拼接操作,显存分配等。
正确性相关
一定要建立自动化的简单 benchmark,建立好 baseline 之后再开始优化。
工作交接相关
AI 改的代码 commit 的时候需要人类读核心 diff 并理解,利于交接。
核心路径需要减少分支,降低人类阅读的心智负担。
似乎可以考虑让 AI 审查核心 diff。
AI 使用相关
1M 的 context 上下文退化比较严重,可以让它生成交接报告,新的 chat 可以获取新的洞见。
Future Exploration
- 为什么有 Batch 总耗时还是会增长。
- 如何评估理论算力和实际耗时的差距。
中国人你要自信
读了可能三分之一,虽然主要是为了水课作业,不过还是可以记一下,确实有一些感触。
- 不要受美国民主专制的叙事干扰,要有自己的话语,超越不仅仅是经济总量和财富。
- 我们站在人类命运共同体的高度,给世界困境开药方。
- 西方仍然抱有零和博弈的思维,推动 “普世价值”,把自己的意志强加于人;中国要引导人类文明走出西方文明“唯我独尊”的困境
- 要处理好现代化与传统的关系,早年中国人失去了对自己文明传统的自信;中国人的文化和信仰就在自己的文字中。
- 中国大部分老百姓对国家和自己的前途感到乐观(2016 年),人均 GDP 不靠谱。混合经济,强调社会和国家的互动。中国是一个超大型的文明型国家。对比台湾和大陆。中国的崛起会带来机会。
- 百国之和,差异巨大的人在同一个文明下生活了数千年。中国有超丰富的文化积淀。(这种积淀的确是非常宝贵的财富)用民主和专制来单纯看待制度是不对的。西方的党是利益集团的党,中国是百国之和,党不可能只代表部分人的利益。
- 中国在给世界带来千年未有之大变局。中非关系。中国极为丰富的历史传统资源可以来塑造新型的全球化。
- 前三十年在拆迁,后三十年在盖房;中国是一个总体进步很快但问题也不少的中国,但问题说得清楚,也有解。很长一段时间,富人移民是网络大V编出来的故事。中国的信仰在自己的文化中,在中国社会总体上有安全感。西方制度容易选出短视的政客。中国是一个文明,而非单纯的一个民族国家。
- 很多照搬西方制度的国家上层和基层是脱节的,没有关注民众的需求。每个国家都应该去探索适合自己的发展道路,但西方有压力。古巴的保守改革模式有问题,政府对社会控制太严,在自己制裁自己。(改革开放很重要)激进改革的代表是苏联。中国的改革是小规模政治改革加大规模经济改革,目的是解放生产力。极左模式(阶级斗争为纲)极右模式(全盘西化)都不对。西方的系数来衡量中国的情况是不够客观的。一个 “主流文明”,如果没有中国参与形成,那就要审慎看待。
- 判断真理的标准是事实,而不是东方或者西方的教条。稳定是中国的第一优先,要”摸着石头过河“,法国属于太激进。
SEUAIG 权限模型
SEUAIG 权限模型
三角色 RBAC
学生、教师、管理员。
管理员只能在数据库中授权,教师只能由管理员授权,所有账号注册时默认为学生。
实际操作引入了超管,所以是 4 角色。
表单型资源实体
包括题目、题单、班级、比赛。
所有操作归类为读操作和写操作。
RBAC 授权:教师具有全部读权限和新建资源权限;学生无权限;
关联授权:新建资源写权限归属创建者;具有写权限的用户可以授权给任意用户任意额外权限;
资源属性授权:指定资源为公开,即授予所有用户读权限。
实际如果有需求可以对实体设置读写管理三种权限层级
资源实体关联
有一个操作是 "把题单关联到班级" 和 "把题目关联到题单"。
存在一个风险:如果学生在班级/题单里,那么应该是能看到关联到班级的题单/题目。实际行为的实现中,如果采用 "只要在班级里就能看到未公开的但是已经关联到班级题单",问题是 "未来作业" 老师是暂时不想公开,但是又加到班级里,不好处理。
解决方案:
- 引入中间资源(作业/题单项)推荐
- 关联表中引入额外字段(本质上是把关联表当作中间资源)
安全性问题
大部分场景其实没有那么高的安全性需求,长尾需求一般还是集中在小圈子,人的社会关系是自然的安全保障。
AI 时代谈测试
NcatBot
Ncat 的一个 Bug。
就是单纯的接口契约没对上,期望要 QQAPIClient 暴露
set_group_add_request 到顶层,实际上接口在
QQAPIClient.manage.set_group_add_request。
因为 QQAPIClient 是符合协议 IQQAPIClient
的实例经过一定的流程组装起来的。
实际上应该要测的是从最开始(裸协议实现)组装起来后有没有这个接口。
SEUAIG
带数据库的项目,测试应该是要有专门的测试数据库。
测试应该专门有一个流程,起测试数据库,测试数据库应该是一次性的,用完就丢。
开发环境 & 测试环境可以统一;生产环境必须独立。
怎么测试?
理想情况下,对于前端,应该有 “从 VO 到展示”,“从交互到副作用” 这两类测试;对于后端,应该是以业务场景分割的端到端测试为主,对于复杂的管线(例如事件总线,消息队列)也可以用集成测试检查下契约和数据流之类的。
不过我现在实践下来很少有 Bug 发生回归,所以比较高效的测试方案是人工做业务端到端测试,写测试反馈,然后交给 AI 去迭代修复。但是这样能 Work 的前提应该是设计者需要有足够好的 Taste 和直觉去评判 AI 的修复方案。
大部分时候让 AI 静态检查一下代码逻辑和结构就能发现很多问题。
我觉得更理想的方式是从设计上减少 Bug 回归的风险,通过合理添加日志来提升定位 Bug 的能力,通过隔离来降低风险,而不是依靠测试去兜底。
AutoWSGR
这个项目有不少复杂性在逻辑上,尤其是 OCR 和识图的操作。针对核心函数的单元测试就很重要。
我构建了针对 OCR 算法、视觉定位算法的单元测试(数据靠人工标注),让 AI 自行迭代算法,效果很不错。
PMEOW
和 SEUAIG 感觉差不多,CI 测试基本没用,检查下 lint 得了。
持续更新中...
邂逅轻轨
记得小学时候有一片课文,主人公经常做梦梦见他在飞,然后被这个梦解读为在长高。
我很喜欢一部系列小说——《2042:背包里的天空》故事中的主角有一双翅膀,因为要避开别人的异样眼光只能将翅膀折叠在背包里。他会飞,但是只能在深夜里翱翔。
看过那部小说之后,我也经常做梦,梦见自己会飞,也许有十多年——从小学五年级到现在。有时候,是科技向,我背着单人飞行器;有时候,是魔法向,我学会了飞行魔法,从五千米的高空掠过沙漠和盆地。
其实也不一定是飞行魔法,传送魔法也可以,闭上眼睛,通过一种特殊的定位方式,将自己传送到高空,伸开双手滑翔,在即将坠地时再把自己传送到安全的地方。
(我穿过水道廊坊,古风拱桥) (传送魔法可能是和苏梦学的)
有时候,干脆是扭曲物理规则,在平坦的地面上起跑,就能获得足够的浮力飞起来,俯瞰下面的实验小学。
偶尔也可以像故事里主人公长出翅膀,在后现代的城市夜空从一栋高楼飞到另一栋。
(东升苑)
我喜欢飞。
又一次梦,我从巡航中的客机坠落,张开翅膀。我看到一片湖,一片行道树,穿行的车流。
在芜湖的轻轨二号线中我找到了那种感觉,像是飞在空中,透过窗外向下看去,镜湖倒映着蔚蓝的天空,脚下是车流和行道树。
梦境和现实的重合总是令人感慨的。
期待下一个美梦。